IEEE
Introduction
本文的主要内容:
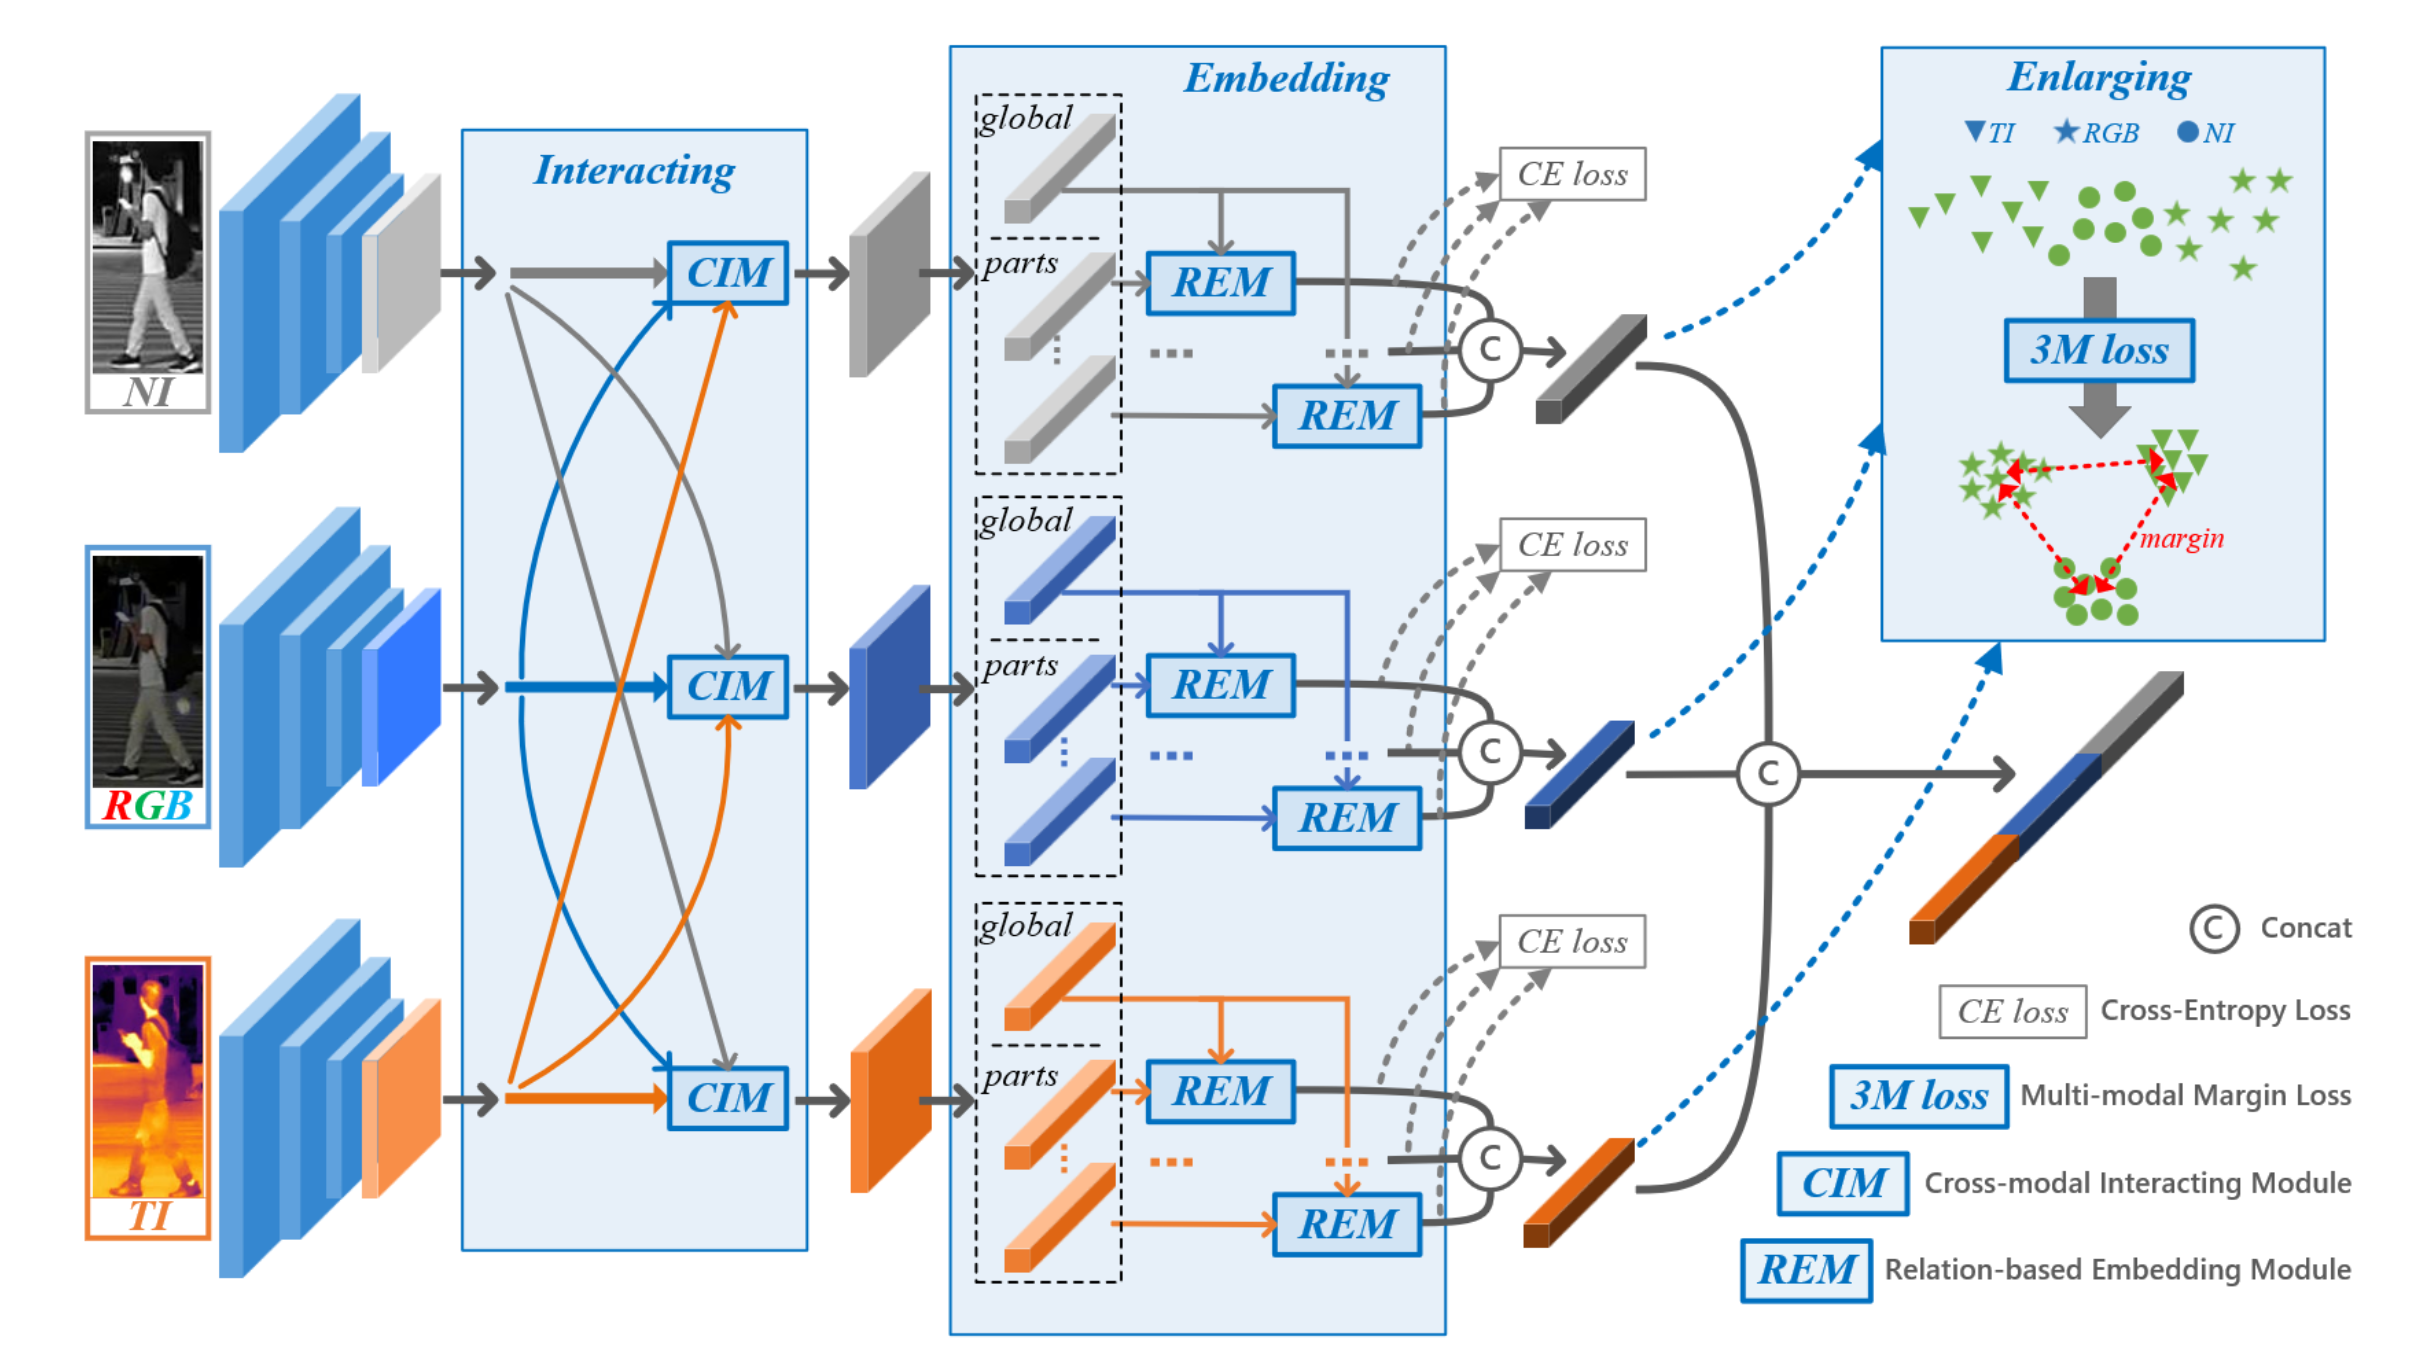
通过交互、嵌入和放大(IEEE) 3个步骤来提升多模态数据的模态特征表示,然后将3个分支的特征连接起来形成最终表示,从而完成多模态行人再识别任务。
- 交互。为了从其他模态中吸收互补信息,同时保持模态相关信息,本文提出了跨模态交互模块(cross-modal interaction module, CIM)来在模态相关特征学习过程中交换模态间的信息。
- 嵌入。为了联合利用局部和全局信息,设计了一种基于关系的嵌入模块(relationship -based embedding module, REM),将全局信息嵌入到细粒度的局部特征中,以增强特定模态的特征表示。
- 放大。为了学习多个模态特征的判别性表示,本文提出一种新的多模态间隔损失(multi-模态margin loss, 3M损失)来扩大不同模态特征的中心距离,降低类内跨模态的相似性。
创新点1:CIM
“To boost the modality-specific information via incorporating the information of other modalities in the fusing phase, we propose a cross-modal interacting module.” (Wang 等, 2022, p. 2633) 重要方法(创新点):
为了在融合阶段通过融合其他模态的信息来增强特定模态的信息,本文提出了一个跨模态交互模块。
本文主张从其他模态中交互/吸收互补信息,同时保留独立/特定模态信息,而不是直接融合。同时,在交互过程中引入通道注意力机制,从其他分支中增强特征的有用信息。通过保留由主干提取的每个模态特征来保存模态特定信息,然后合并来自其他模态的特征,然后通过通道注意力来加强重要区域。将融合后的特征与原始特征进行交互。值得注意的是,这三个模态特征仍然是独立的,而不是融合为一个单一的特征。在继续独立训练的同时,每个模态分支在交互后将不再影响其他模态分支。
创新点2:REM
“To boost the fine-grained information by global feature while capturing both local and global information during feature learning, we propose a novel relation-based embedding module for ReID.” (Wang 等, 2022, p. 2634) 重要方法2(创新点):为了在特征学习过程中利用全局特征提升细粒度信息,同时兼顾局部和全局信息,本文提出了一种新的基于关系的重识别嵌入模块。
具体地,我们将全局信息嵌入到细粒度部件特征中,以增强每个部件特征的表达能力。经过此嵌入模块后,每个分支的特征既包含局部特征的局部细节,又包含吸收的全局信息。
【重要】创新点3:3M Loss
“To boost the feature discrimination among modalities, while simultaneously considering the intraclass cross-modal incongruities and inter-class discrepancies in multi-modal Re-ID, we propose a novel multimodal margin loss (3M loss).” (Wang 等, 2022, p. 2634) 重要方法3(创新点):为了增强多模态Re-ID的模态间特征区分度,同时考虑多模态Re-ID中类内、跨模态的不一致性和类间的差异性,提出了一种新的多模态间隔损失(multi-modal margin loss, 3M loss)
以前的损失函数方法:中心损失通过减小类内距离来聚集每个类别中的所有样本。为了降低不同模态之间的异质性,HC损失限制了共享同一身份的模态中心之间的距离。
以前方法的缺点:交叉熵损失和中心损失仅利用了身份信息,缺乏对模态间关系的考虑。HC损失只注重增强数据的异质性,而忽略了多模态数据之间的互补性。
本文方法的特点:如图2(e)所示,除了通过传统的CE损失在身份层面上强化类间差异外,本文还通过进一步扩大同一身份在不同模态上的中心距离来强化类内跨模态不一致。3M损失可以进一步迫使网络学习特定模态的特征,而不是模态共享的信息。
Related Work
“Multi-modal Fusion Schemes” (Wang 等, 2022, p. 2634) 多模态融合方案相关工作:
可以分为早期融合、晚期融合和渐进融合:
- 早期融合(图像级融合)。它将具有一致信息的多模态数据融合到单个输入中,然后进行后续的网络训练。然而,这类融合方法强调主观视觉效果,只融合浅层纹理信息。
- 后期融合(特征级融合)。广泛应用于人脸抗欺骗、显著目标检测、目标跟踪等领域。它们通常将相应分支提取的多模态特征集合起来,得到最终的特征表示。然而,由于多模态之间存在较大的异质性,它们无法关注具体的模态信息。
- 渐进式融合方法。逐步融合多模态特征,而不是一次融合,可以提高互补信息的积极效果,更好地聚合各个模态的细节。然而,它忽略了模式之间的异质性,这可能包含区分不同人的关键判别信息。
“Cross-modal and Multi-modal Re-ID” (Wang 等, 2022, p. 2634) 跨模态和多模态ReID相关工作
因为可见光在暗光下的局限性,提出了跨模态行人Re-ID数据集SYSU MM01和RegDB,分别通过引入近红外和热模态来解决这一问题。但是可见光和近红外/热图像之间的显著差异是跨模态行人重识别的主要挑战。
为了用额外的模态补充RGB信息,提出了RGBNT201等深度数据集。PFNet通过多分支网络提取不同模态的特征,然后在部分级逐步融合两种模态(RGB-NI和RGB-TI),从而建立Baseline。然而,它忽略了利用模态之间的不同异质性。
方法论
三流特征提取网络
使用ResNet50作为Backbone,分别提取特征,由于三个分支的参数不共享,因此特征包含各自模态的信息。
跨模态交互模块(CIM)
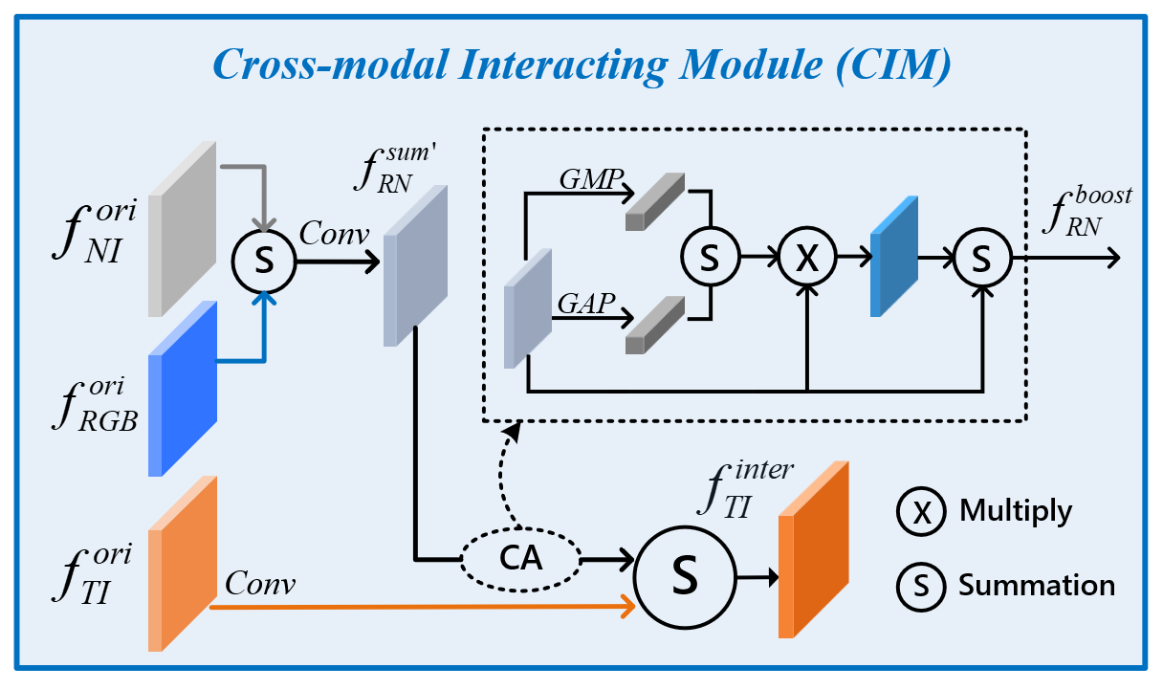
我们通过求和来整合其他模态的信息,然后通过使用通道注意力来增强来自其他模态的有用信息。最后,为了保持当前的模态信息,我们通过求和将增强后的特征与当前的模态特征结合起来。交互将重复模态总数次。
模态是如何交互的?
“Figure 4” (Wang 等, 2022, p. 2636) CIM模态交互的过程(TI为例)
首先,我们对主干网提取的 RGB 特征$f_{RGB}^{ori}$和 NI 特征$f_{NI}^{ori}$进行像素级求和,以获得交互特征$f_{RN}^{sum}$。然后,我们在$f_{RN}^{sum}$和 TI 特征$f_{TI}^{ori}$上实现1×1卷积层,以获得$f_{RN}^{sum’}$和$f_{TI}^{ori’}$。然后对$f_{RN}^{sum’}$进行通道注意力CA,得到$f_{RN}^{boost}$最后,将$f_{RN}^{boost}$和$f_{TI}^{ori’}$相加得到$f_{TI}^{inter}$,即为与其他模态交互之后的TI模态。另外两个模态同理。
基于关系的嵌入模块 (REM)
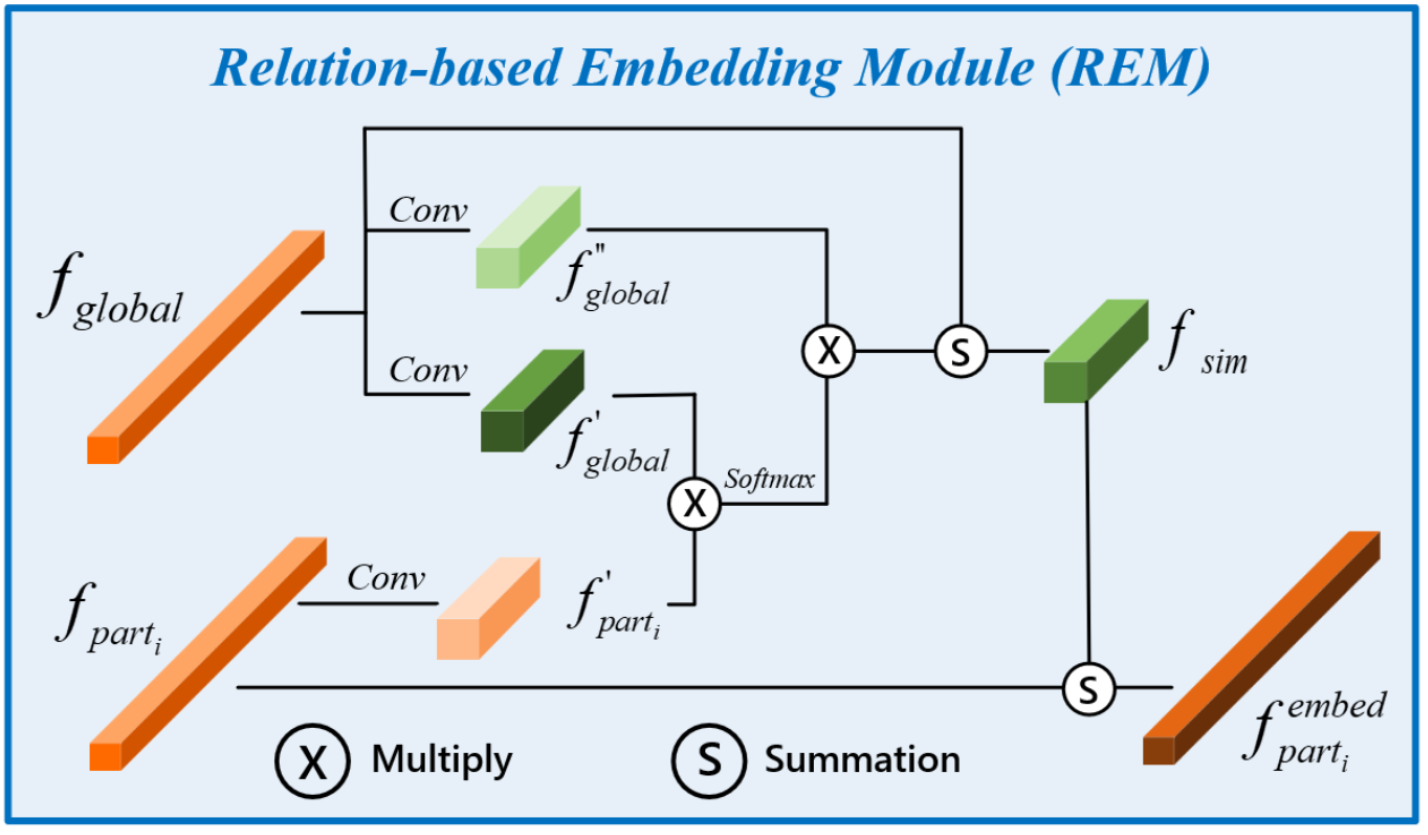
传入的是在CIM中得到的$f_{TI}^{inter},f_{NI}^{inter},f_{RGB}^{inter}$ ,
首先进行自适应平均池化,获得全局特征$f_{global}$ 和P局部特征$f_{part_i},i\in[ 1,…,P]$ ,然后将全局信息嵌入到每个细粒度的部分特征中。
这部分以$f_{TI}^{inter}$得到的第i部分特特征为例,使用局部特征$f_{part_i}$和全局特征$f_{global}$来引入REM模块。
首先,我们在部分和全局特征上实现三个1×1卷积层以获得$f’{global}$,$f’’{global}$和$f’{part_i}$,然后我们对$f’{part_i}$和$f’{global}$进行点积运算然后通过softmax得到它们的相似度作为权重来衡量全局和部分之间的关系,即:$V{sim}=f’{part_i} \odot f’{global}$ 。最后,为了整合全局信息和细粒度局部信息,我们对 $f_{sim}$ 和原始零件特征进行求和运算,得到特征$f_{part_i}^{embed}$
$$
\begin{aligned}&f_{sim}=f_{global}+V_{sim}*f_{global}^{‘’}\&f_{part_i}^{embed}=f_{part_i}+f_{sim}\end{aligned}
$$
通过全局特征单独增强每个部分,然后将所有部位特征连接起来,得到TI模态的嵌入特征$f_{TI}^{embed}$,同理,其他两个模态也是如此操作。
最后把三模态的嵌入特征concat起来作为最终表示:$f_{final}=C(f_{TI}^{embed},f_{RGB}^{embed},f_{NI}^{embed})$
多模态边界损失(3M Loss)
为什么要提出这样一个损失函数?
- 在多模态人员ReID中,每个人由三个模态图像的三元组组成。3M损失是为了扩大每个三元组中模态中心之间的距离。提出的3M损失旨在增加类内模态信息的多样性,同时确保ID之间的区分度。
这个3M Loss损失是如何计算的?
具体来讲,
$$
L_{3M}=Max(|margin-d(m_{j}, m_{k})|),\space m_{j},m_{k} \in {RGB, NI, TI}
$$
- margin 表示每两个模态之间的预期中心距离,默认为1
- $d(m_{j},m_{k})$表示$m_j$和$m_k$模态中心之间的L2距离
ID损失不是采用3M损失,而是采用了交叉熵损失:
$$
L_{CE}=-\Sigma_{m=1}^M\Sigma_{p=1}^Py^{GT}\log{y_{p}^m}
$$
- P表示条带(part)数量
- M表示模态(Modal)数量
- 而 $y^{GT}$ 和 $y_{p}^m$ 分别是 m 模态中第 p 个部分(局部)特征的真实标签和预测身份标签
最终的损失函数为:
$$
L_{final} = L_{CE} + \delta \times L_{3M}
$$
其中delta损失的平衡超参数。
和跨模态ReID的区别
跨模态再识别主要解决两种模态之间的异质性,旨在从另一种模态的图库中查询单一模态的图像。
而多模态再识别则专注于在相同多模态条件下查询多个模态图像,强调多模态数据之间的互补性。
跨模态再识别方法在多模态场景下表现不佳,因为它们缺乏对多模态互补信息的利用,并且存在跨模态异质性问题。
实现细节
在 ImageNet 上预训练的三个 ResNet50 网络作为主干来提取特征。
原始学习率设置为0.001,我们在epoch 20和epoch 40中将学习率降低10倍。
mini-batch的数量为8。
CIM模块后的特征图被平均分割为6个条带(part)。
FC层将每个零件特征的维度减少到128。
因此,每个模态的特征维度$f_{embed}$为 6 × 128 = 768,个体的最终特征($f_{final}$)为 768 × 3 = 2304维。
训练阶段同时使用交叉熵损失和多模态边缘损失,我们将多模态边缘损失中的边缘设置为1,最终损失中的δ设置为1。
我们使用随机梯度下降(SGD),动量为0.9 和权重衰减 0.0005 来微调网络。
实验
在基准多模态行人重识别数据集 RGBNT201进行评估,并基于 Market1501构建了多模态数据集,并与SOTA比较
数据集和评估协议
RGBNT201不用多说。
如何Market1501构建的数据集:
- 我们首先通过 CycleGAN 从 RGB 图像生成 TI 模态图像。
- 然后我们将 RGB 图像转换为灰色图像作为补充 NI 模态。
- 最后,为了模拟夜景,我们将 RGB 模态的所有图像的亮度降低了 60%。
评估协议。通过欧氏距离来测量两个特征之间的相似度。使用mAP和CMC和其他方法进行比较。
和SOTA相比
IEEE的比较对象
- 多模态:PFNet、HAMNet
- 单模态:MLFN、HACNN、OSNet (在每一个上实现单模态方法进行特征提取,然后将所有特征连接起来作为ReID的特征表示)
结果:达到了SOTA,单模态 ReID 方法通常比多模态方法黯然失色。
原因:
- 【单模态的缺点】单模态方法缺乏处理异构多模态信息的能力。此外,这些方法不能有效地挖掘不同模态之间的互补信息,而这对于多模态 Re-ID 至关重要。【另外两个多模态的缺点:】
- 【其他多模态的缺点】作为代表性的多模态 Re-ID 方法,HAMNet 设计了异质性协作损失来强制每个分支的预测结果。然而,它对多流主干的输出使用加法操作,忽略了不同模态之间特征交互的重要性。尽管PFNet旨在发现多模态数据之间的互补信息并提出了渐进式融合方案,但它过于关注融合特征,而失去了对模态特定信息的敏感性。
因此,HAMNet和PFNet 在多模式人员重新识别方面的改进有限。我们的方法(IEEE)显着提高了 mAP 和rank的性能,这验证了我们的方法在融合互补信息的同时抑制多模态数据之间的异构问题的有效性。
与跨模态 Re-ID 方法的比较
为了验证多模态 Re-ID 与跨模态场景相比的必要性,我们将多模态数据集 RGBNT201 构建为跨模态设置。具体来说,我们保留 RGB 和 TI 图像以实现与 RegDB 相同的模态设置,并保留 RGB 和 NI 照片以模仿 SYSU 数据集。为了公平比较,我们在相应的两种模态场景上评估我们的方法。我们将我们的模型与三种最先进的跨模态行人重识别方法进行比较,包括 HC loss、DDAG和MPANet。由于不同模态之间存在巨大的异质性,所有三种跨模态 Re-ID 方法都表现出中等的性能。相反,我们的方法通过利用互补的多模态信息实现了有希望的性能,这验证了多模态 ReID 的有效性。
消融实验
成功证明了CIM,REM和3M的有效性。
跨模态交互模块评估
为了评估所提出的 CIM 的有效性,我们将我们的 CIM 与一种早期融合方案(图像求和)、两种后期融合方案(特征求和和特征聚合)如 JL-DCF和DAPNet进行比较,以及渐进融合方案 PFNet。
后期融合和渐进融合都比早期融合要好。这主要是因为早期的融合方法融合了图像通道级的浅层信息,并且可能同时聚合不同模态之间的噪声。相比之下,在后期和渐进融合方案中,卷积网络处理的特征包含更多的模态特征信息,比特征级别的融合获得更好的精度。考虑到融合阶段不同区域的重要性,我们的 CIM 在模态之间交换信息,同时对特征的不同区域进行加权,从而获得卓越的性能。
3M Loss评估
优点:所提出的多模态边缘损失(3M Loss)旨在通过扩大多模态特征中心的距离来提高模态信息的多样性。
比较对象:交叉熵(CE)损失、异质中心损失(HC)、中心损失。
其他方法的缺点:
- 与传统的CE损失相比,中心损失进一步抑制了类间差异,但由于缺乏多模态数据的关系,它无法区分模态级别的特征分布。
- 通过考虑模态之间的异质性,HC损失聚合了同一个人的不同模态特征,然而,它仍然忽略了互补的多模态数据中特定模态的信息学习。
- 3M损失同时扩大了类内跨模态距离,提高了类间跨模态距离。通过学习补充模态特定信息来实现差异。
结论
本文提出了一种新颖的多模态行人重新识别方法,通过模态间交互、部分全局嵌入和类内跨模态距离扩大来增强模态特定表示。
总体流程:
- 首先,它通过三流网络提取多模态特征,并通过跨模态交互交换有用信息。
- 此外,它嵌入全局信息以增强个体模态的局部细粒度特征。
- 此外,为了探索每种模态的跨模态互补信息,它通过所提出的多模态边缘损失扩大不同模态之间的中心距离来学习模态特定特征而不是模态相似信息。
在具有挑战性的多模态行人重新识别数据集上进行的大量实验证明了我们提出的方法的性能。