Code
环境配置
/Python 3.8 /torch 1.6.0 /torchvision 0.7.0 /timm 0.3.2 /cuda 10.1
项目文件结构
| 目录 | 目录 | 介绍 |
|---|---|---|
| \config | 配置类 | |
| \config\defaults.py | 使用yacs定义了config类,用于管理整个训练过程中的所有参数,在类间进行参数传递。 | |
| \configs | 模型配置文件 | |
| \configs{DukeMTMC, Market, MSMT17, OCC_Duke, VehicleID, VeRi}* | configs中保存的是各种数据集配置文件的目录。 | |
| 在各个数据集目录中,存放了不同配置的模型,比如baseline,只添加了JPM或者只添加了SIE,完整的TransReID模型,以及不同图片大小的和不同stride大小的模型,方便进行模型对比。 | ||
| \configs\transformer_base.yml | 不带有JPM和SIE的Baseline模型 | |
| \datasets | 数据集 | |
| \datasets\make_dataloader.py | 用于加载数据集 | |
| \datasets\bases.py | 存放各个数据集的基类和制作ReID图像数据集的类 | |
| \datasets{dukemtmcreid.py, market1501.py, msmt17.py, occ_duke.py, vehicleid.py, veri.py} | 各种数据集子类,用于初始化各种数据集 | |
| \datasets\keypoint_{test,train}.txt | veri数据集的相关数据 | |
| \datasets\preprocessing.py | 制作数据集的时候随机擦除部分数据 | |
| \datasets\sampler.py | 随机采样 | |
| \datasets\sampler_ddp.py | DDP采样 | |
| \loss | 损失函数 | |
| \loss\make_loss.py | 用于根据配置返回损失函数 | |
| \loss\center_loss.py | 中心损失 | |
| \loss\arcface.py | ||
| \loss\metric_learning.py | ContrastiveLoss,CircleLoss,Arcface,Cosface,AMSoftmax | |
| \loss\softmax_loss.py | softmax损失 | |
| \loss\triplet_loss.py | 三元组损失 | |
| \model | 模型 | |
| \model\make_model.py | 用于生成模型框架 | |
| \model\backbones\resnet.py | 以resnet为backbone | |
| \model\backbones\vit_pytorch.py | 以vit为backbone | |
| \processor | 处理过程 | |
| \processor\processor.py | 进行训练或者推理 | |
| \solver | ||
| \solver\cosine_lr.py | 余弦学习率 | |
| \solver\lr_scheduler.py | 学习率调度器 | |
| \solver\make_optimizer.py | 制作优化器 | |
| \solver\scheduler.py | 调度器 | |
| \solver\scheduler_factory.py | 调度器工厂函数 | |
| \utils | 工具类 | |
| \utils\iotools.py | IO工具 | |
| \utils\logger.py | 日志工具 | |
| \utils\meter.py | 计数器 | |
| \utils\metrics.py | 各种矩阵计算函数,R1,mAP,欧几里得距离等 | |
| \utils\reranking.py] | person re-ranking算法 | |
| \dist_train.sh | 分布式训练的启动脚本 | |
| \test.py | 测试主程序 | |
| \train.py | 训练主程序 |
项目总体流程
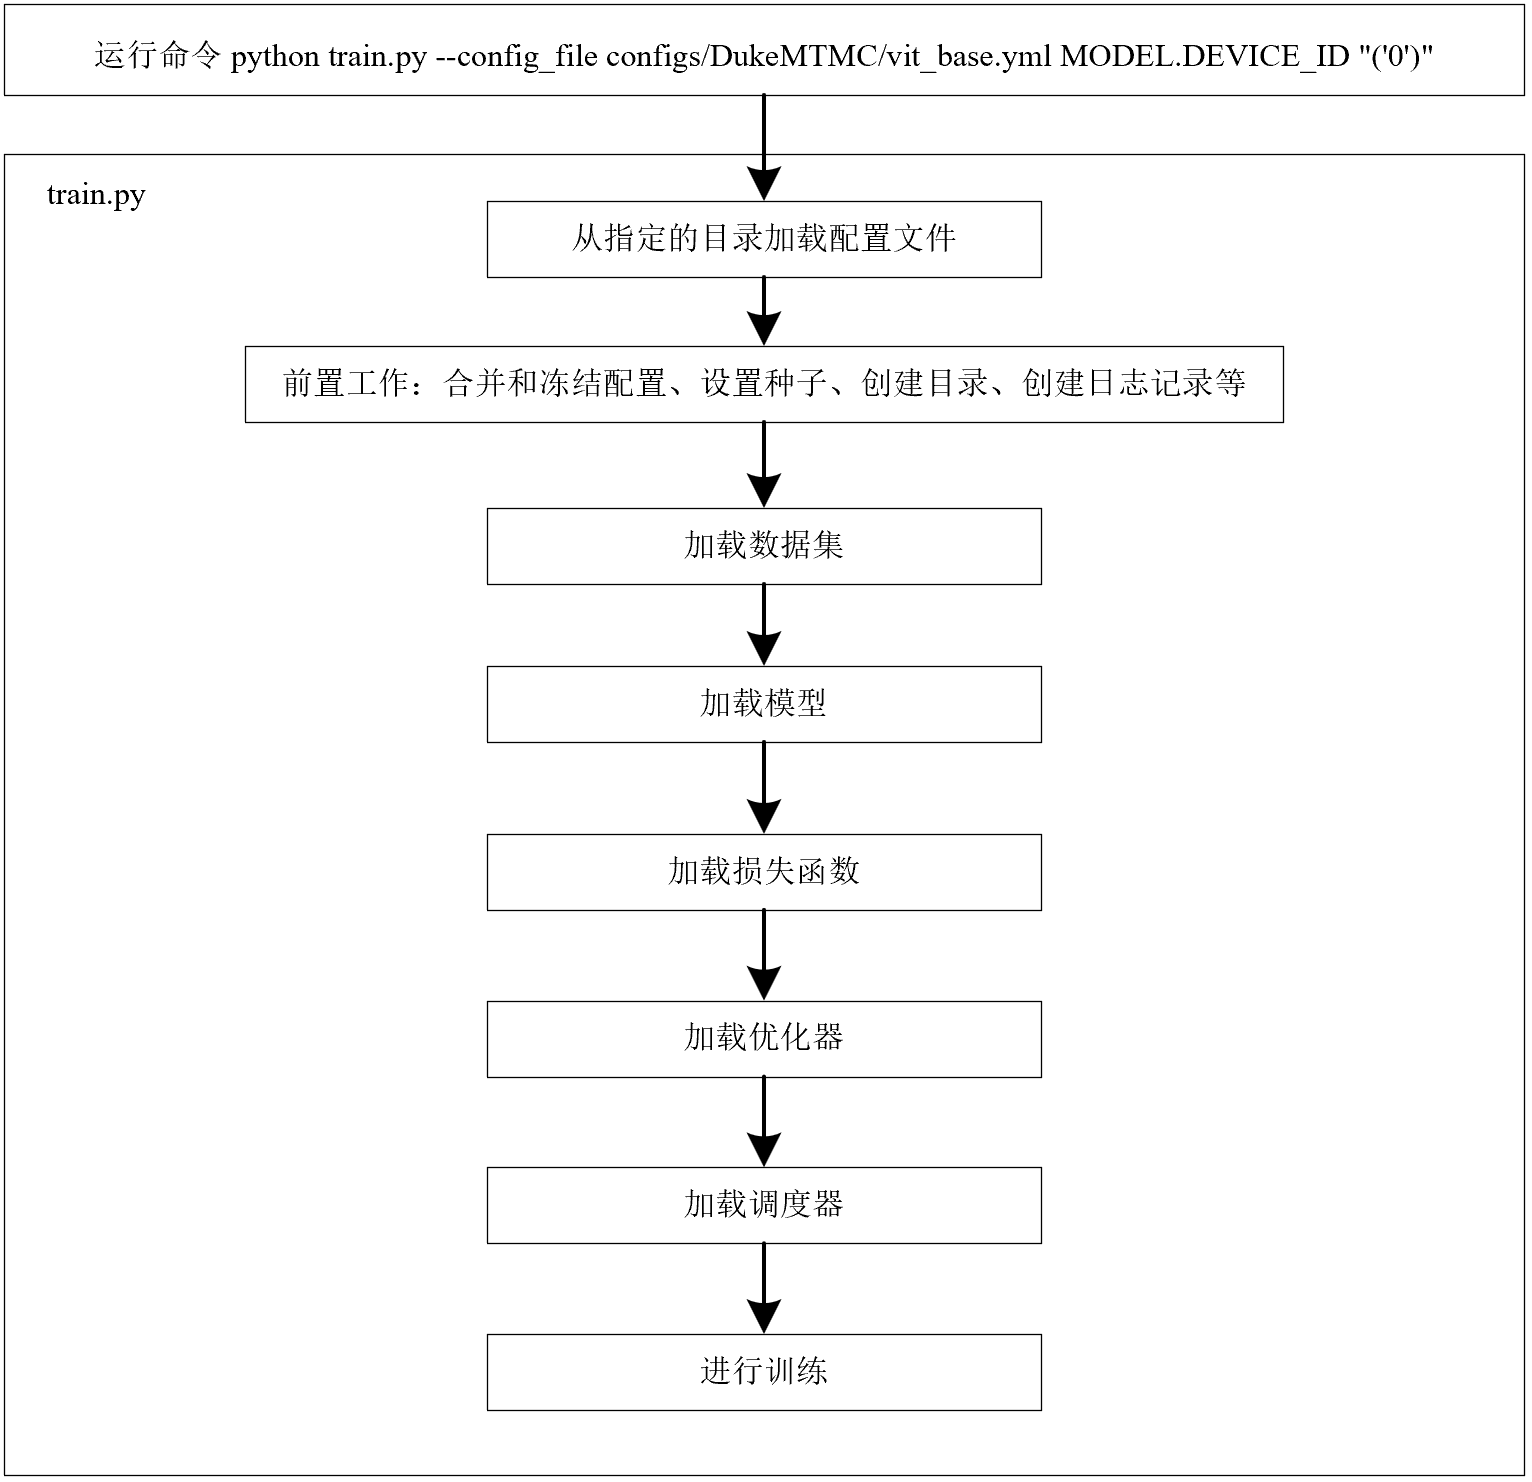
模型基本流程
使用命令行提供参数进行训练:
1 | python train.py --config_file configs/transformer_base.yml MODEL.DEVICE_ID "('your device id')" MODEL.STRIDE_SIZE ${1} MODEL.SIE_CAMERA ${2} MODEL.SIE_VIEW ${3} MODEL.JPM ${4} MODEL.TRANSFORMER_TYPE ${5} OUTPUT_DIR ${OUTPUT_DIR} DATASETS.NAMES "('your dataset name')" |
或者在IDE内配置Additional Arguments之后,在IDE内直接运行。
准备工作
命令参数中--config_file configs/Market/vit_transreid.yml指明了配置文件。然后将此配置文件和默认配置文件合并。默认配置文件在目录\config\defaults.py中,本项目使用了yacs定义了config类,用于管理整个训练过程中的所有参数,在类间进行参数传递。
加载参数之后使用cfg.freeze()进行冻结,防止在训练的过程中被修改。随后指定目标设备,是否进行分布式训练。创建日志输出目录和模型输出目录,用于在训练的过程中进行日志记录,并在结束之后创建模型文件。
加载数据集
1 | train_loader, train_loader_normal, val_loader, num_query, num_classes, camera_num, view_num = make_dataloader(cfg) |
make_dataloader()函数定义在\\datasets\\make_dataloader.py中,用于读取各个数据集,其过程如下:
数据增广:在制作dataloader的过程中,对训练集和验证集采用不同的数据增广方案。对于训练集:首先使用双三次插值将图像调整到指定尺寸,然后随机水平翻转图像,填充像素,在图像中随机裁剪出一个固定大小的区域,将图像转换为张量之后进行归一化,最后对图像进行随机擦除【顺序有要求:调整大小–>随机翻转–>填充–>裁剪–>张量–>归一化–>擦除】;对于验证集:只进行调整大小,转换为张量并进行归一化即可。【两者的方案有区别的原因是:两者的目的不同,训练集是为了通过数据增广提高模型的鲁棒性和泛化能力,使模型能够学习到更多的图像特征,从而提升模型在真实场景中的表现。而验证集用于评估训练后的模型在标准化数据集上的表现,确保模型在不带增广的情况下也能有良好的表现,确保模型能够正确处理没有增广的数据。】
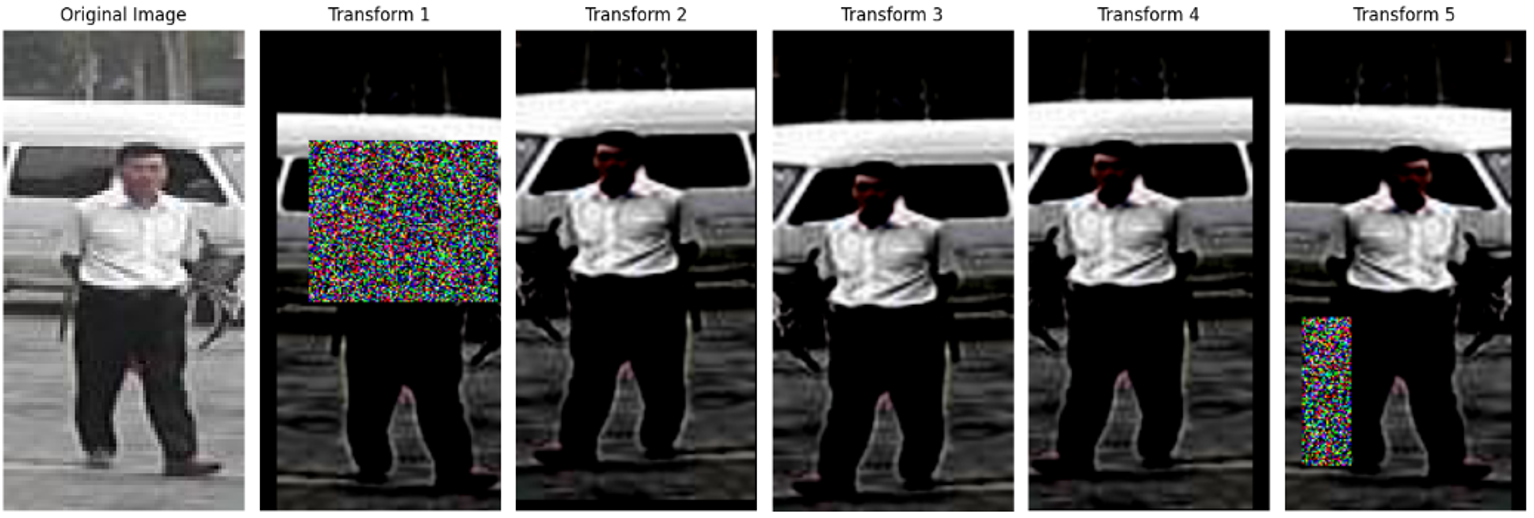
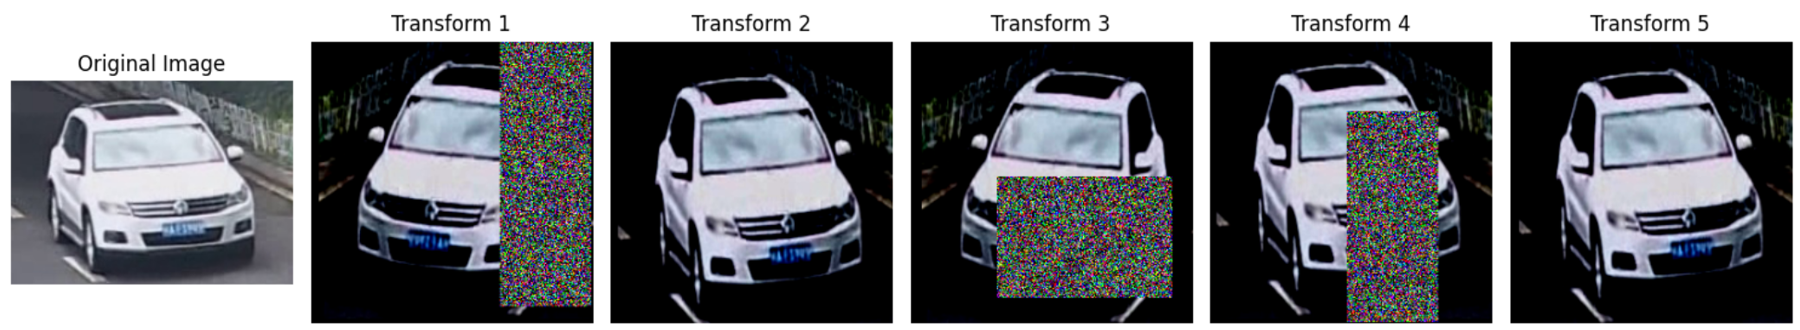
进行数据增广获取训练集和正常训练集之后,从目标数据集中获取目标类别数量class_num、镜头数量cam_num、视角数量view_num。然后需要将数据集dataset转换为ImageDataset,我们需要使用转换后的ImageDataset制作DataLoader。
制作数据加载器: 根据采样器类型和是否进行分布式训练制作train_loader。本文使用了随机个体采样器【随机抽取N个身份,然后对每个身份随机抽取K个实例,因此批量大小N * K】,此时会根据是否是分布式训练分为两种情况,如果不是分布式训练,则直接使用随机个体采样(RandomIdentitySampler),如果使用了分布式训练,则使用分布式数据并行的随机个体采样(RandomIdentitySampler_DDP)制作train_loader。
然后制作val_loader和train_loader_normal,也就是验证集加载器和不经过变换的训练集。
最后依次返回train_loader, train_loader_normal, val_loader, len(dataset.query), num_classes, cam_num, view_num
不同图像数据集的统一
需要为各个数据集实现不同的数据集读取类,如market1501.py, msmt17.py等,这是因为每个数据集的目录结构不一定相同,但需要为dataloader提供统一的格式,我们的实现方法是先实现每个数据集的dataset类,然后将其封装进ImageDataset从而为DataLoader提供数据。
dataset的制作: 本项目中为图像数据集定义了BaseImageDataset(继承自BaseDataset)作为父类,用于实现获取数据集统计信息的方法;所有的数据集类继承这个类。
所有图像数据集类的实现方法大致相同,需要先指定获取train, query, gallery等数据集的目录,然后通过_self_._check_before_run()函数检查上述目录是否存在,随后通过_self_._process_dir()函数生成数据集。最后打印数据集信息并将数据集划分后分配给相关的成员变量如_self_.train, _self_.query _self_.gallery,以及使用继承自父类的方法获取各个集合的元数据信息比如不同个体的数量,图片的数量,摄像头数据量,视角数量等。
至此,该可访问的数据集中的train, query, galery 已经可被访问,同时,也可以获取每个集合的pid, img, cam, vid的数量。但是,此时还没有真正把图片数据读取到内存,因为此时dataset中存储的是图片路径img_path。
封装进ImageDataset: 在make_dataloader的时候,会将dataset传入ImageDataset,从而为DataLoader提供统一的格式,在ImageDataset中传入dataset和transform进行初始化,该类实现了getitem双下方法,在此方法中,只有访问图片的时候才会读取图片并将图片执行transform变换,然后返回相关的数据,此时图片才真正读取到内存。
加载模型
1 | model = make_model(cfg, *num_class*=num_classes, *camera_num*=camera_num, *view_num* = view_num) |
本例以Market1501数据集为例,使用Vit-B/16+JPM+SIE作为示例模型,配置文件为/configs/Market /vit_transreid.yml
整体模型
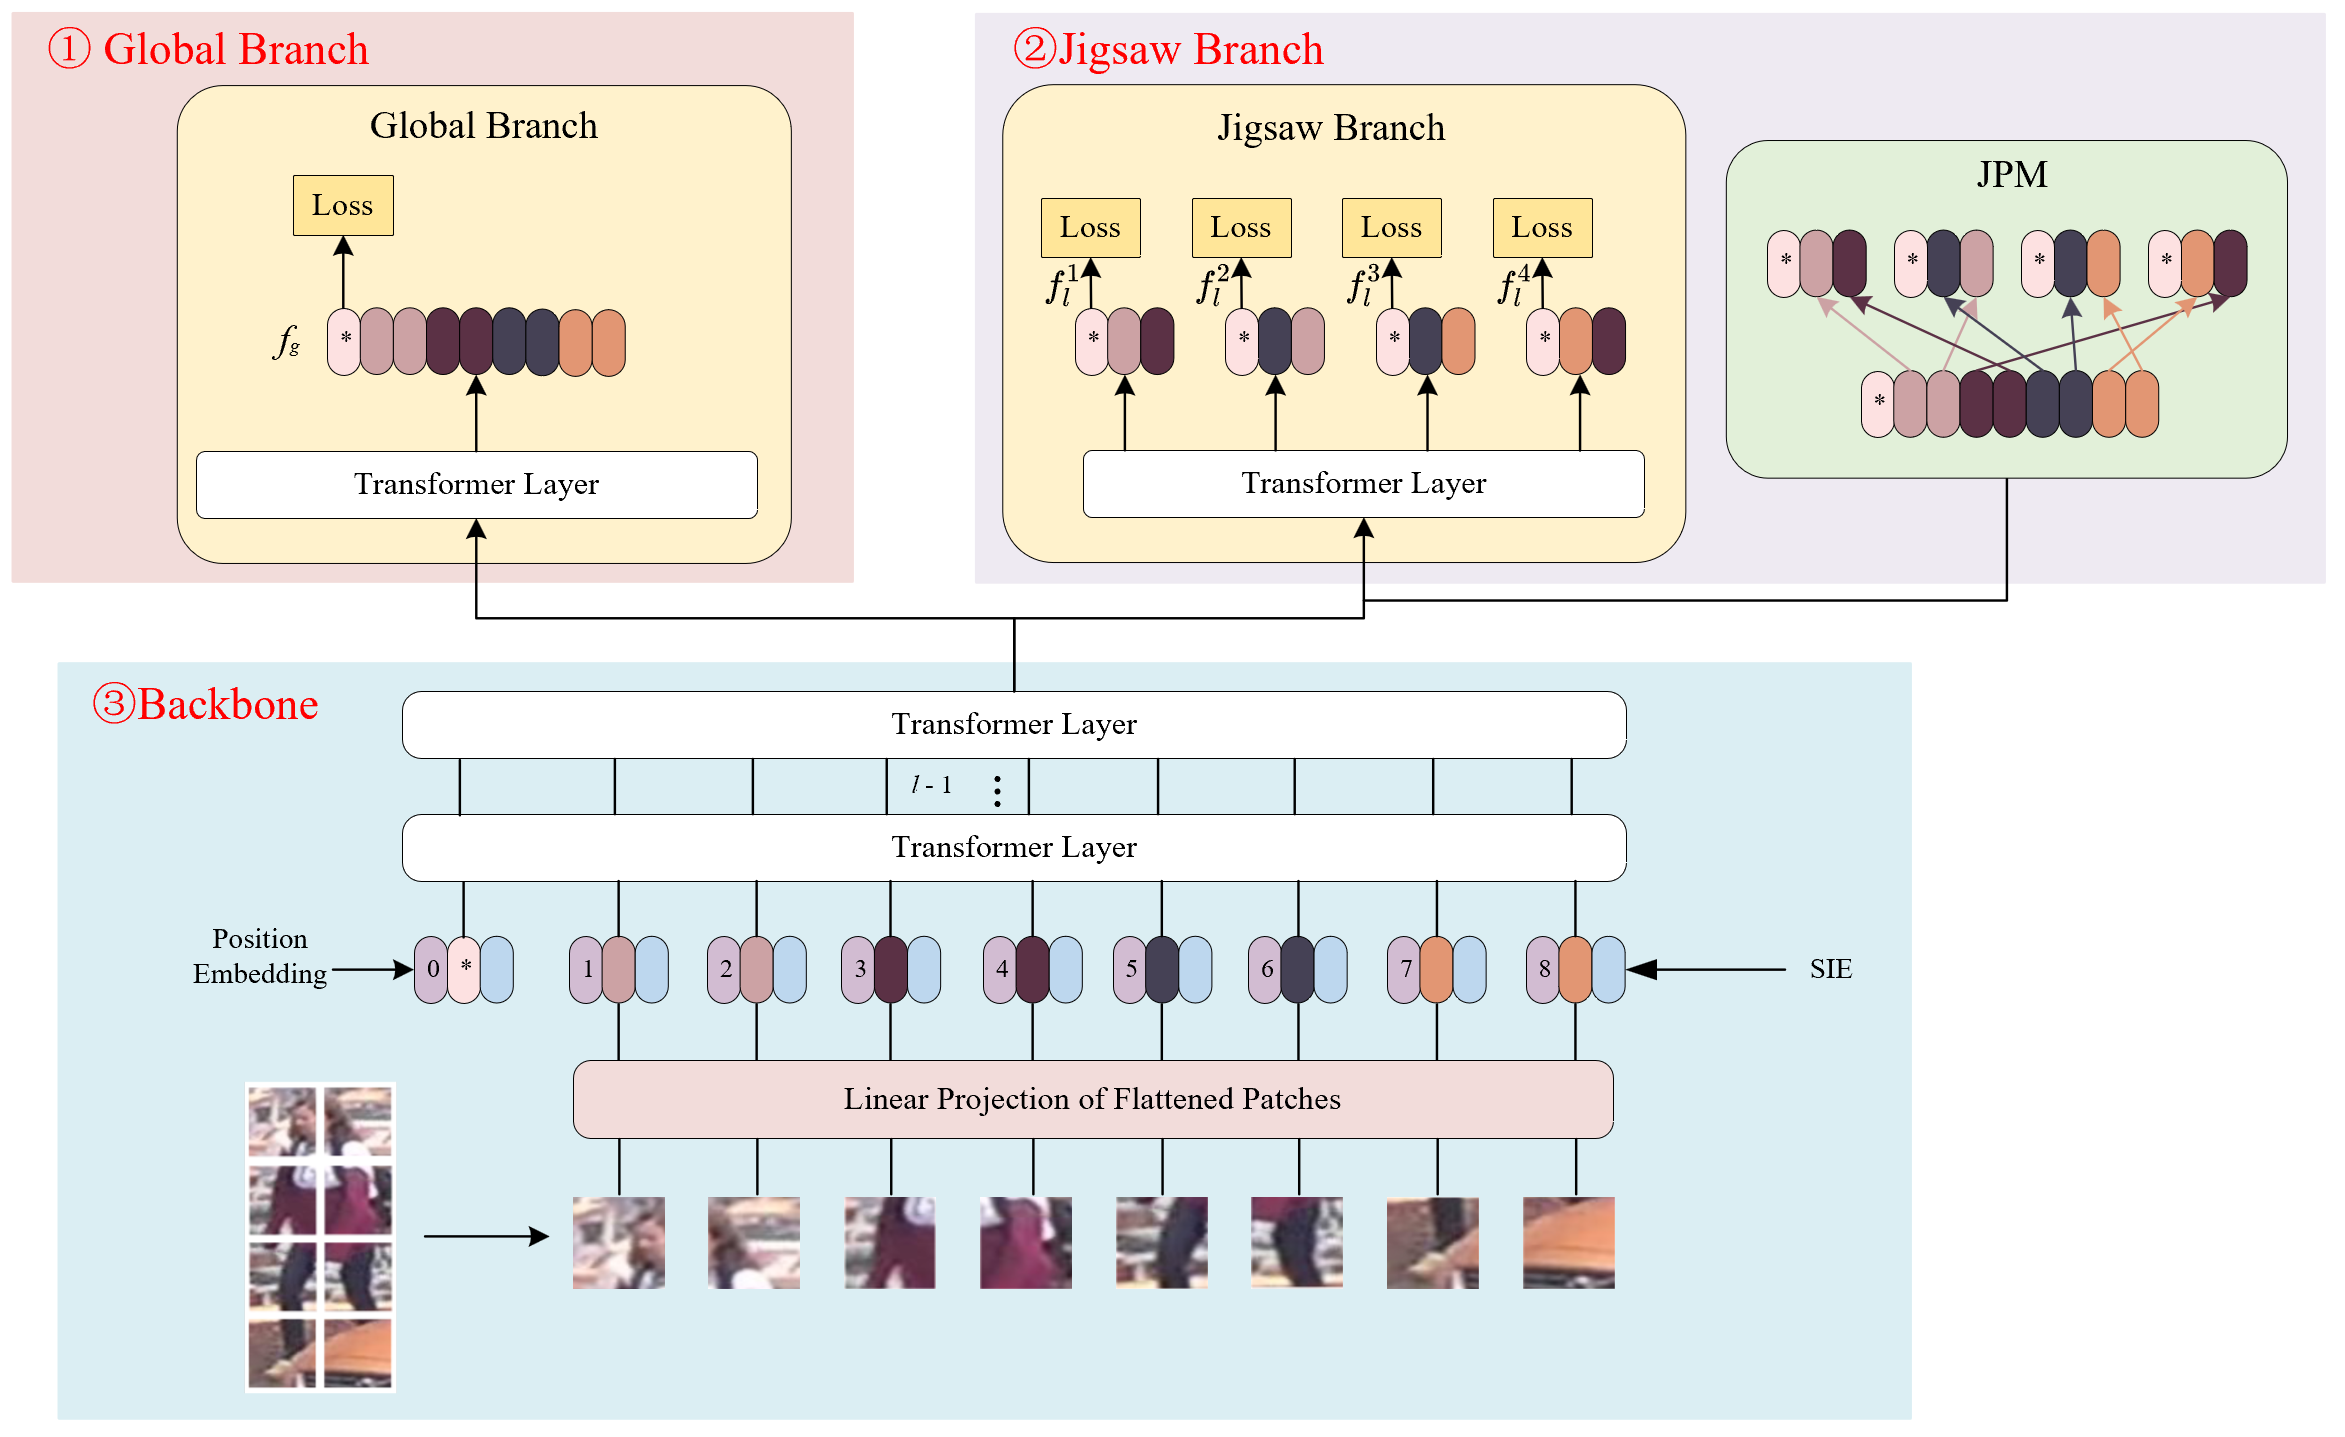
在初始化中,设置基本配置参数,如预训练模型路径、预训练选择、是否使用余弦层、瓶颈层类型以及测试时的特征选择。并用self.in_planes定义了输入通道数。根据配置文件设置相机和视角信息。
使用 factory 字典创建指定类型的Transformer模型(SIE实现在Backbone内部),并传递各种超参数。相当于图中的①部分,代表Backbone,用于提取特征。
从Backbone中提取最后一个block(Transformer Layer)和layer_norm层,并分别复制这些层用于Global Branch和Jigsaw Branch,相当于②和③的Transformer Layer
根据配置文件中的损失类型MODEL.ID_LOSS_TYPE选择不同的分类器,包括 Arcface、Cosface、AMSoftmax 和 CircleLoss 等。如果未指定特殊的损失类型,则使用标准的线性分类器,并为每个局部特征分别创建一个分类器,包括了1个Global Branch和4个Jigsaw Branch的分类器。
随后创建用于获取全局特征和局部特征的BottleNeck层,共5个,分别用于Global Branch和Jigsaw Branch。
至此,整体模型搭建完毕。
在进行前向传播运算的时候,首先用Backbone抽取出特征features,然后分别处理全局特征和局部特征:
全局特征:将特征通过self.b1(Global Branch层中的Transformer Layer+LN层)进行处理,从而提取全局特征。
局部特征:计算除去第一个token的特征长度和每个patch的长度,提取出第一个token特征。将特征长度划分为self.divide_length个部分(该常量定义在config/defaults.py中,默认为4)。然后对特征进行重排(JPM)。分别提取4个局部特征块,并与token连接。通过self.b2(包含一个 Transformer 块和LN层)处理每个局部特征块。提取每个局部特征块的第一个特征向量作为局部特征向量。
然后对上述过程得到的1个全局特征和4个局部特征分别进行批量归一化处理,得到最终的全局特征feat和局部特征local_feat_{1,2,3,4}_ bn。
随后根据是否正在训练,返回不同的变量:正在训练时,返回对应损失类型相应分类器计算分类得分。否则使用线性分类器的分类得分,返回分类得分concat之后的值和归一化之前对应的特征;测试的时候会根据self.neck_feat返回归一化之前或者之后的特征用于查看运行结果。
Backbone
调试记录使用的配置文件为/configs/Market/vit_transreid.yml,主要配置为:STRIDE_SIZE=[16, 16],SHIFT_NUM=8,图像大小为256x128,batsh_size为32,patch大小为16x16。
输入数据的大小(B,C,H,W)为(32,3,256,128),图5中写明了每个步骤之后数据的形状。
![[image-20240731180354.png | 600]]
Linear Projection of Flattened Patches:图像按照批量大小输入进入Backbone之后,首先进行拆分为重叠的Patches然后进行线性映射,具体方法为将其输入特定kernel和stride的卷积层【这里的Overlap是通过控制不同的patch_size和stride_size实现的。其中stride_size是超参数步长,需要提前配置,本例为[16,16],当这个数值小于patch_size的时候会将图片分成重叠的块,让模型学习到连续的信息;patch_size是块大小,默认为16】。然后展平最后的H和W维度,最后交换最后两个维度。这样一来,输入的图像就被映射成了(批量大小,图像块,嵌入维度)形状的张量,本例中为(32,128,768)。
CLS, Position Embedding and SIE: 对于上一步的张量,为其添加一个CLS token,拼接起来变成(32,129,768),然后为CLS和每个Patch添加Position Embedding和SIE信息(SIE信息同时考虑了相机和视角信息),然后将x以一定概率进行丢弃,本模型中基于vit的模型此概率都为0,因此可以忽略不计。此时的张量形状为(32,129,768)。
Transformer Blocks: 将上述张量输入Transformer Block,依次通过并以一定的概率丢弃某一层,这里的丢弃概率是由drop_path_rate决定的,本例中为0.1。此时分为两种情况,是否是具有JPM的架构:如果没有JPM,则直接将数据依次通过depth个Transformer Block(本例为12个),直接进入Global Branch从而直接提取Global Feature;如果存在JPM,则需要依次通过depth - 1个Transformer Block,最后的一个block在Global Branch和Jigsaw Branch中分别有一个。
无论如何,本例中Backbone提取出的Feature大小为(32,129,768),即(批量大小,块数量+1,嵌入维度)。
Global Branch
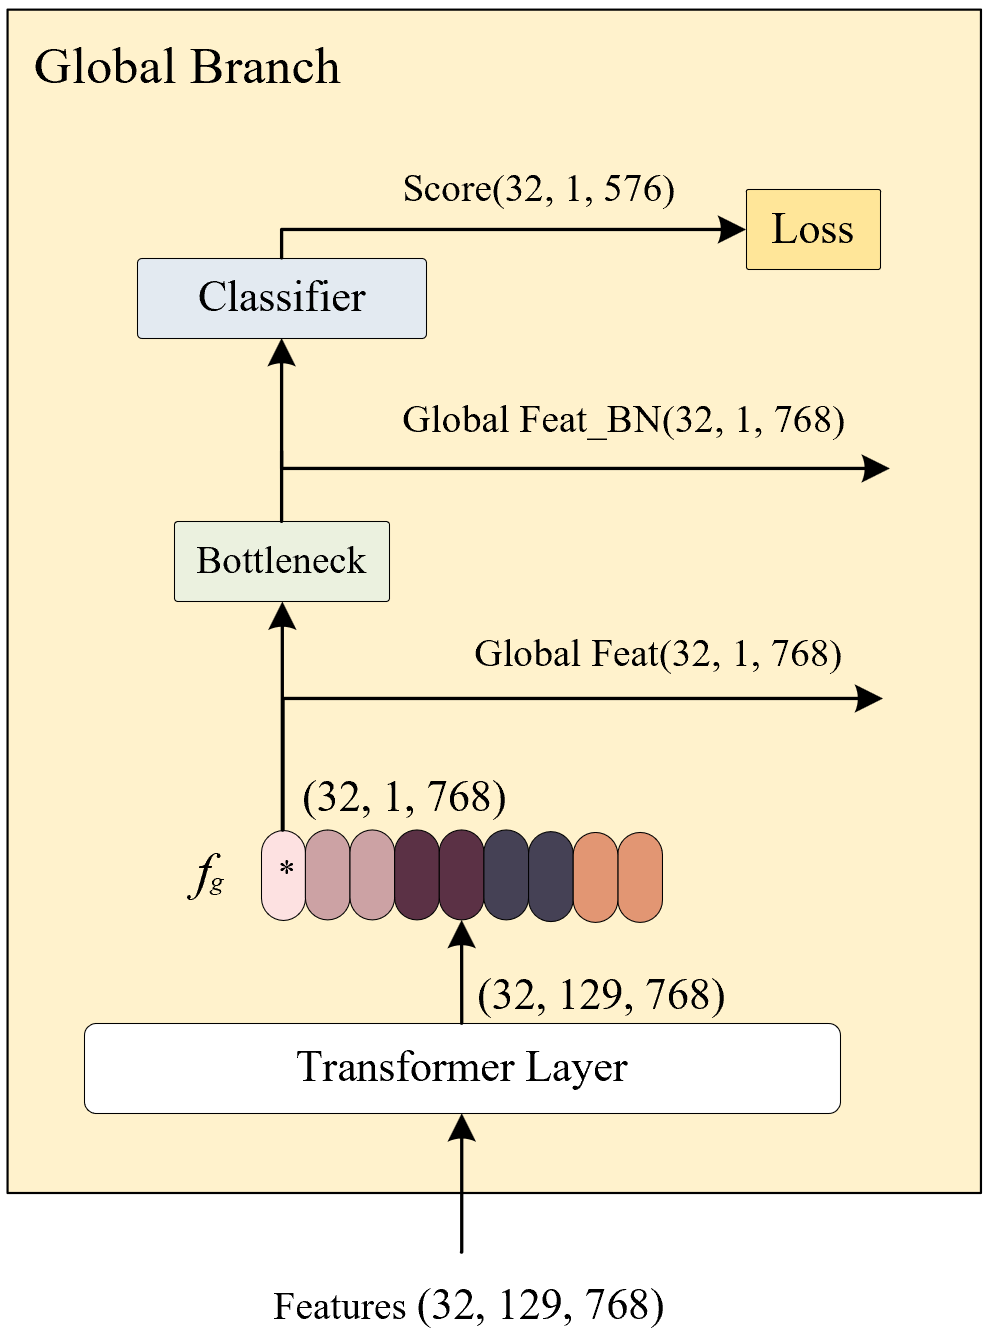
如图6所示,全局注意力会直接将Backbone提供的特征送入最后一个Transformer Layer进一步提取特征,然后拿出来class token作为全局特征。另外,本文中还实现了BottleNeck层用于将其正则化,然后再送入分类器以获得类别信息。
Jigsaw Branch
本例中,shuffle_group=2,divide_length=4,shift_num=8输入的特征为(32,129,768)
Jigsaw Patch Module: 进入JPM的patch不包括class token,也就是特征为(32,128,768),在进入JPM之后,会先对各个patch进行移位操作,本例中移位的数量是8,也就是说[1,2,3…128]会变成[9,10,…128,1,2,…8],然后会进行随机打乱,在进行随机打乱的时候分成shuffle_group组,也就是2组进行的,打乱之后会还原成原来的形状(32,128,768),进入下一步操作。
Jigsaw Branch: 特征通过了JPM之后,会按照devide_length的数量分成4组,4组分别和class token拼接,拼接之后分别进入Transformer Layer,得到最后的特征,也就是说会得到4个形状为(32,33,768)的张量,然后提取其class token进入bottleneck层进行正则化,最后进入classifier得到分数。
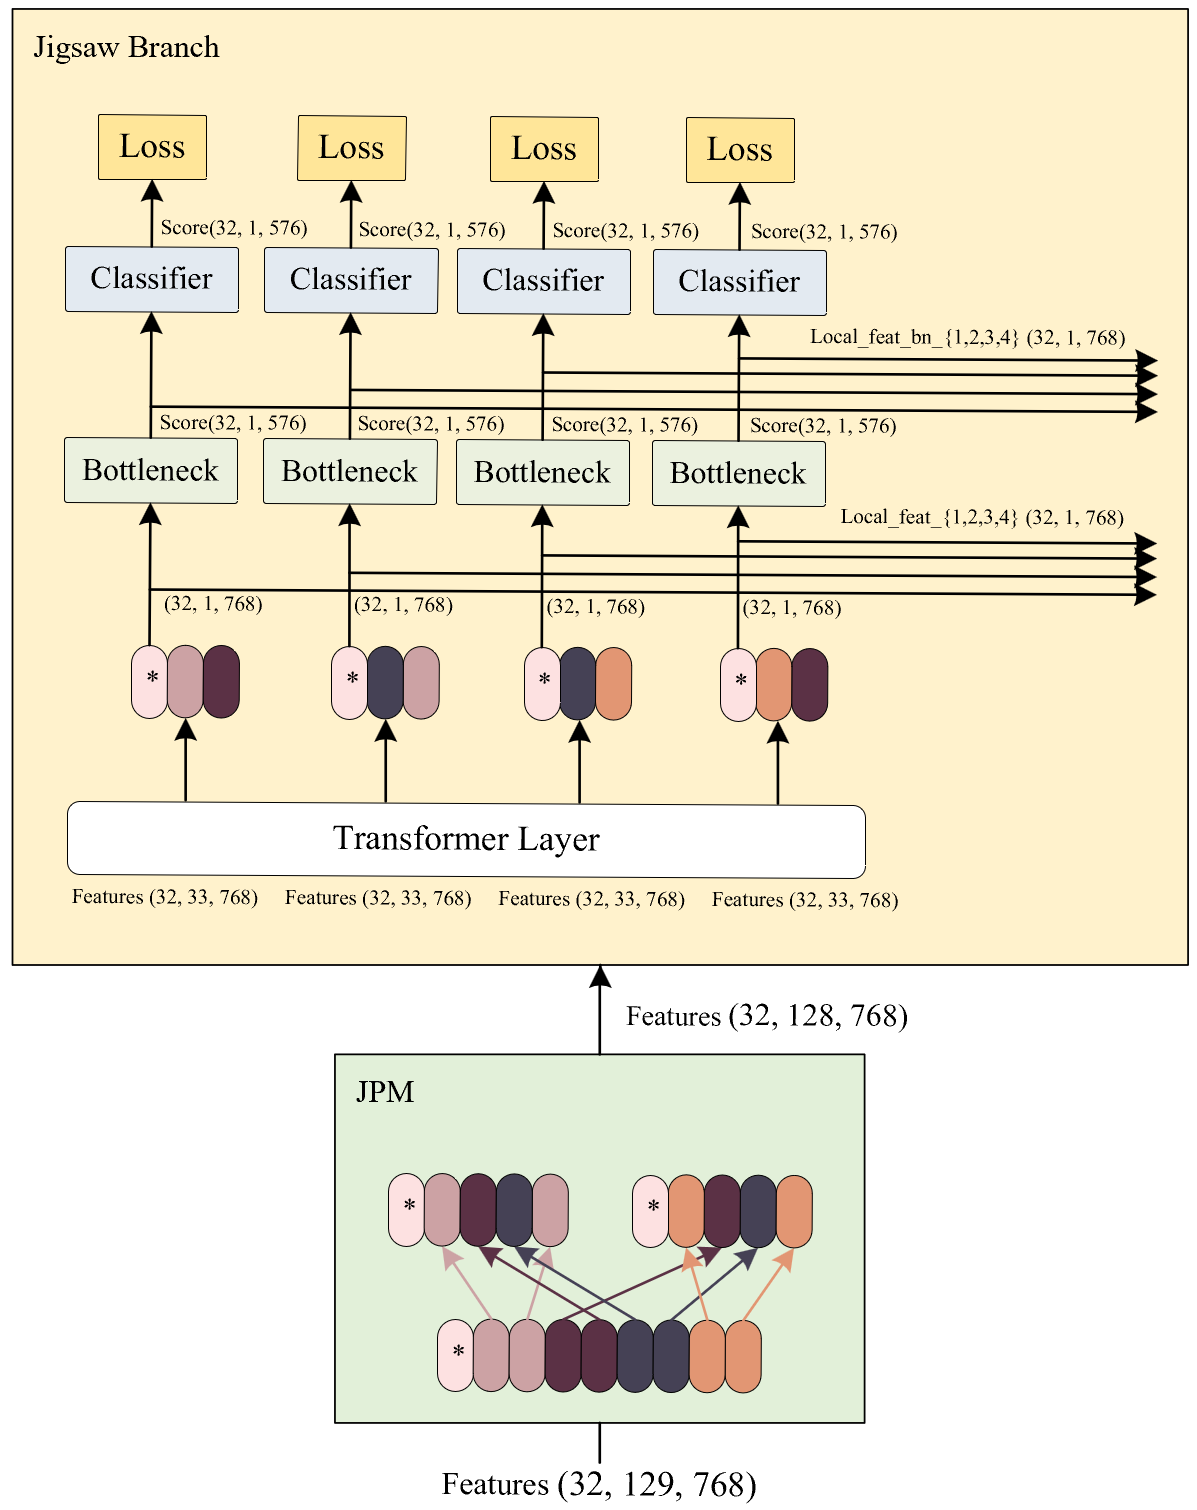
损失函数
1 | loss_func, center_criterion = make_loss(cfg, *num_classes*=num_classes) |
首先检查配置中的度量损失类型(MODEL.METRIC_LOSS_TYPE)是否为 triplet,然后使用MODEL.NO_MARGIN决定使用软三元组损失还是有边界的三元组损
如果配置中启用了标签平滑(Label Smoothing),则初始化交叉熵标签平滑损失(Cross Entropy Label Smooth)
然后根据采样器定义损失函数。如果采样器类型为 softmax,则定义一个简单的交叉熵损失函数。如果采样器类型为triplet,则返回以下损失函数(度量损失类型(MODEL.METRIC_LOSS_TYPE)为 triplet的时候才有效):
首先判断是否采用了标签平滑,如果启用了标签平滑,如果 score 是列表,计算每个得分的标签平滑交叉熵损失,并取平均值;否则,直接计算标签平滑交叉熵损失。如果 feat 是列表,计算每个特征的三元组损失,并取平均值;否则,直接计算三元组损失。最后返回 ID 损失和三元组损失的加权和。
如果未启用标签平滑,计算类似的交叉熵损失和三元组损失。
ID损失
使用得分score计算ID损失,只有在损失类型为三元组损失的时候才会单独计算ID_LOSS。ID损失的计算分为有没有启用平滑标签两种情况。
当启用了平滑标签的时候:首先判断score是否为列表,如果不是列表,则直接计算平滑标签交叉熵损失;如果是列表,说明使用了Global Branch和Jigsaw Branch,形状为 [cls_score, cls_score_1, cls_score_2, cls_score_3, _score_4] ,其中score中的第一个元素为Global Branch的loss,其他为Jigsaw Branch的loss,此时的算法为:将Jigsaw Branch的loss计算平滑标签的交叉熵损失,然后求平均avg,然后将Global Branch的loss求平滑交叉熵损失之后,和上一步得到的avg分别以0.5的权重相加,得到最后的ID_LOSS。
如果没有启用平滑标签,则将平滑标签的交叉熵损失更换为普通的交叉熵损失,后续算法同上。
本文中的ID_LOSS采用了没有标签平滑的交叉熵损失。
度量损失(三元组损失)
使用特征feature计算三元组损失,无论是否启用标签平滑,TRI_LOSS的计算方式是一样的。
feat的形状为[global_feat, local_feat_1, local_feat_2, local_feat_3, local_feat_4],如果不是列表,则直接计算三元组损失;如果是列表,则使用和ID损失相似的算法,先计算局部信息的平均损失,然后将其和全局信息的损失求平均后得到最终的三元组损失。
优化器
1 | optimizer, optimizer_center = make_optimizer(cfg, model, center_criterion) |
首先初始化一个空列表 params 用于存储模型参数和对应的学习率、权重衰减。使用 model.named_parameters() 获取模型参数的名称和值。如果参数不需要梯度(requires_grad 为 False),则跳过该参数。
然后设置学习率和权重衰减:默认情况下,学习率 lr 设置为配置中的基础学习率 BASE_LR,权重衰减 weight_decay 设置为配置中的 WEIGHT_DECAY。如果参数名称包含 “bias”,则调整学习率和权重衰减,分别乘以 BIAS_LR_FACTOR 和 WEIGHT_DECAY_BIAS。如果配置中指定了 LARGE_FC_LR(对全连接层使用较大的学习率),且参数名称包含 “classifier” 或 “arcface”,则将学习率设置为基础学习率的两倍,并打印提示信息。最后将参数和值添加到 params 列表中,包括参数的学习率和权重衰减。
最后创建模型优化器并返回:根据配置中的优化器名称创建相应的优化器。如果优化器名称是 ‘SGD’,则使用 SGD 优化器,并设置动量(momentum)。如果优化器名称是 ‘AdamW’,则使用 AdamW 优化器,并设置学习率和权重衰减。对于其他优化器,使用 getattr 动态获取并创建优化器;然后为中心损失创建一个单独的SGD优化器,设置学习率为CENTER_LR。
学习率调度器
1 | scheduler = create_scheduler(cfg, optimizer) |
从配置对象中获取最大训练轮数num_epochs,然后配置学习率。
lr_最低学习率,为基础学习率的0.2%,学习率预热阶段的初始学习率,为基础学习率的1%,从配置对象中获取预热阶段的轮数。
最后创建一个余弦学习率调度器 CosineLRScheduler,并传入各种配置参数。
模型训练
1 | do_train(cfg, model, center_criterion, train_loader, val_loader, optimizer, optimizer_center, scheduler, loss_func, num_query, args.local_rank) |
准备工作:从配置对象中获取日志记录周期、检查点保存周期和评估周期。设置设备为 “cuda” 并获取最大训练轮数。初始化日志记录器并打印开始训练的消息。将模型移动到指定设备(GPU)。如果有多个 GPU 并且启用了分布式训练,则使用分布式数据并行模式进行训练。初始化度量器loss_meter和acc_meter以记录损失和准确率。初始化评估器evaluator和梯度缩放器scaler。
训练循环:每次循环处理一个训练轮次。重置度量器和评估器,更新学习率,并将模型设置为训练模式。对于每一个epoch:将优化器的梯度清零。将数据和标签移动到设备。使用自动混合精度进行前向传播,计算损失。反向传播和梯度更新。
如果使用中心损失,调整中心损失的梯度并更新。计算并记录准确率和损失。每隔一定批次,打印日志信息。
计算并记录每个批次的训练时间和训练速度。每隔一定轮次保存模型的检查点。对于分布式训练,仅在主进程中保存。
每个循环结束进行验证:每隔一定轮次进行验证。对于分布式训练,仅在主进程中进行验证并记录结果。计算并记录 mAP 和 CMC 曲线。
实验结果

Baseline为基本的vit_base结构
TransReID-c-s为vit_transformer+JPM+SIE完整模型,并且stride=12
由于时间原因没有跑完所有的结果。
精读报告
问题动机
现有方法的局限性:
- 基于CNN的方法主要关注小的判别区域,无法在全局范围内利用丰富的结构模式进行ReID。最近的一些工作虽然引入了注意力模块来探索远距离的依赖关系,但大多数都嵌入在深层中,并没有解决CNN的原理问题。
- 图像的细粒度特征很重要,但是CNN的下采样算子(例如池化和跨步卷积)降低了输出特征图的空间分辨率,这会导致图像细节丢失。
新技术的出现:
ViT和DeiT表明在特征提取方面,纯Transformer的效果可以和基于CNN的方法一样有效。基于 Transformer 的模型适合解决基于 CNN 的 ReID 中的上述问题,原因如下。
- 多头自注意力捕获了长距离依赖性,并驱动模型比 CNN 模型关注不同的人体部位。
- 无需下采样算子,Transformer就可以保留更详细的信息。
解决思路
模型框架如上图所示,该模型由三部分组成:骨干网络、全局特征和局部特征分支,该模型思路如下:
- 构建了基于纯Transformer的strong baseline框架。将Vision Transformer(ViT)作为特征提取的基础,利用其全局注意力机制捕捉图像中的长距离依赖关系,从而克服CNN主要关注局部区域的问题。
- 重叠图像块(Overlapping Patches):通过使用滑动窗口生成重叠的图像块,而不是ViT中使用的非重叠图像块,保留了更多的局部结构信息,有助于学习更鲁棒的特征。
- 位置嵌入(Position Embeddings):引入可学习的2D位置嵌入,以适应ReID任务中可能变化的图像分辨率,为Transformer提供了不同位置的信息。
- 监督学习:结合ID损失和三元组损失对模型进行优化,以提高模型对不同身份的区分能力。
- 引入了Side Information Embedding(SIE)。引入SIE模块来编码非视觉信息,如相机ID和视点信息,以减少由于相机或视点变化导致的特征偏差,增强特征的不变性。
- 提出了Jigsaw Patch Module(JPM)。设计了JPM来重新排列图像块的嵌入,通过位移和洗牌操作生成更具有辨别能力和全局上下文的鲁棒特征。
- 最终结果和特征不止由全局的特征判断,而是使用全局特征和局部特征共同判断。
- 设计了特定的损失函数,将全局特征和局部特征的损失值进行拼接优化,用以适配提出的模型。
方法亮点
- 纯Transformer应用:TransReID是首次将纯Transformer应用于ReID研究,展示了Transformer在特征提取方面与CNN方法相媲美的潜力。
- 重叠图像:通过使用滑动窗口生成重叠的图像块,而不是ViT中使用的非重叠图像块,保留了更多的局部结构信息,有助于学习更鲁棒的特征。
- 拼图块模块(JPM):通过位移和打乱操作重新排列图像块的嵌入,生成具有改进辨别能力和更多样化覆盖的鲁棒特征。
- 边信息嵌入(SIE):引入了一个统一框架,通过可学习的嵌入直接将非视觉线索(如相机ID和视点信息)编码,以减少特征偏差。
主要结果
TransReID在多个ReID基准测试中取得了最先进的性能,包括:
- 在行人ReID方面,TransReID在MSMT17和DukeMTMC-reID数据集上显著超越了先前的SOTA,在Market-1501上,其性能和SOTA相当。
- 在车辆ReID方面,TransReID在VeRi-776和VehicleID数据集上达到了新的最高精度。
存在问题
- 计算成本:Transformer模型通常需要较高的计算资源,尤其是在处理高分辨率图像时。
- 模型泛化能力:尽管TransReID在多个基准测试中表现优异,但其泛化到未见过的场景和摄像头设置的能力仍需进一步验证。
- 数据依赖性:TransReID的性能可能依赖于大规模的预训练数据集,对于数据受限的情况,其性能可能会受到影响。
自己的思考
与传统的目标检测和定位不同,Re-ID(Re-Identification,重识别)的根本任务是在不同的摄像头视角或在不同的时间点捕获的图像中识别和匹配相同的个体或对象。本文中,使用了基于Vision Transformer的框架作为Backbone,这种架构具有全局感知的能力,并且作者在后期使用JPM进行了优化,使其在细节感知方面也有较强的能力。
总的来说,本文从前期特征提取和后期处理两个方面对原有的架构进行了优化:
- 在前期特征提取中,作者受到Transformer Encoder中Positional Encoding的启发,在Patches添加了表示不同的摄像机或者视角的SIE信息,这种信息和Position Embedding一起为Patches添加了位置信息。同时,为了避免原生ViT中整块切割Patches导致的不同图像块的上下文信息丢失问题,作者使用了重叠的图像块来避免这种问题。
- 在后期处理方面,作者为了避免整个模型只关注全局信息的问题,做了两点优化:一是为全局信息和局部信息采用了不同的分支,在最终判定的时候使用两个分支共同决定的结果。二是设计了一个JPM模块,该模块能够通过位移和洗牌操作让模型更具有辨别能力。
此外,本文作者对代码进行了开源,通过阅读程序源码,可以发现本项目的源码质量非常高,整个项目目录结构清晰完整,各个目录的功能清晰简明,包组织合理。并且作者在源码中应用了非常多的Python语法特性和优秀的编程思想,比如本项目利用了Python静态多态实现了不同数据集的统一,使用了函数闭包进行模型加载、损失函数和优化器的加载等,使用了工厂模式的设计模式,使用了图像延后加载使显存占用降低,使用了日志组件进行记录,使用了yacs进行全局配置文件的管理,并且为项目开发编写了几个工具类便于使用等等。
但是,本项目在源码方面也有微瑕(也可能是作者没有开源相关代码)本文中使用了Grad-CAM算法对中间特征进行了分析,此部分代码尚未公开,需要自己书写工具类和相关逻辑来实现相关功能。我计划在未来的一周实现相关功能。