Notes
mCSP的计算
mCSP用于衡量车辆重识别模型在跨场景检索中的性能。mCSP特别关注于抑制来自同一摄像头但视角相似的正样本,从而更真实地反映模型在复杂城市监控系统中的跨摄像头检索能力。
VCNet是如何提取视角信息的?
使用了在ImageNet上进行预训练的Res50。然后先在数据集776上进行视角信息的预训练(使用了IBN-Net-Res50)
然后在muri数据集上重新训练viewpoint特征提取网络。这一部分使用CELoss作为监督。
因为776是有标签的,所以训练出来的模型会带有视角信息。
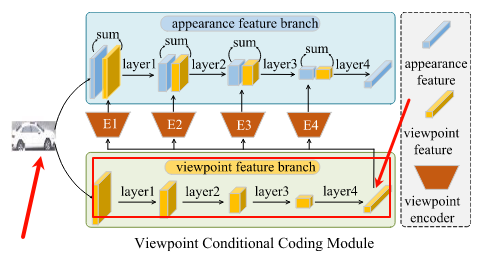
本文的VCC模块就是将车辆图片输入了viewpoint feature branch中获取了视角信息,然后将这种信息输入了外观提取模块。
流程整理
本文中,训练的时候每次取一张图片,而不是对多个模态进行分别提取和融合,而,
在训练的时候每张图片只有一次输入,那么viewpoint信息是如何参与训练的???
是通过VCC提取的,VCC中有两个分支,专门用于提取appearance和viewpoint的特征
那么,这两种特征是如何提取的?
分为视角信息提取和外观特征提取,其中视角信息会融合到外观信息中【本文中为什么要用这两种架构对两种信息进行提取??这两种模型分别有什么优势???后续我是否可以针对两种信息分别进行处理呢??也就是说弄出来两个模块分别对两种信息进行处理,然后分别进行融合。。。】
也就是说,整个过程中没有利用到图片的标号信息【后续创新可以结合不同的标号/视角——SIE!!进行一个embedding,然后嵌入进embeded patches里面】
在VCC模块中,我们可以得到两种信息——视角信息和外形信息。
然后这两种信息是如何利用的?
局限性
CVFR中假设模型缺失了1个viewpoint,实际情况可能只能捕捉到一个viewpoint。
VCNet - Original
Abs
现有的车辆重识别方法主要依赖于单一查询,车辆表示信息有限,在复杂的监控网络中严重阻碍了车辆重识别的性能。
在本文中,我们提出了一个更现实、更容易访问的任务,称为多查询车辆 Re-ID,它利用多个查询来克服单个查询的视点限制。
本文的三大贡献:
- 设计了一种新的视点条件网络 (VCNet),它自适应地组合来自不同车辆视点的互补信息,用于多查询车辆 Re-ID。针对车辆视点缺失的问题,我们提出了一种交叉视点特征恢复模块,通过学习可用视点和缺失视点特征之间的相关性来恢复缺失视点的特征。
- 我们创建了一个统一的基准数据集,由来自真实交通监控系统的 6142 个摄像头拍摄,具有每辆车的综合视角和大量交叉场景,用于多查询车辆 Re-ID 评估。
- 设计了一个新的评估指标,称为平均跨场景精度 (mCSP),它通过衡量来自同一相机的具有相似视点的正样本来衡量跨场景识别的能力。
综合实验验证了所提出的方法相对于其他方法的优越性,以及所设计的指标在多查询车辆 Re-ID 评估中的有效性。
Intro
机遇:
- 一方面,在特定场景中,我们可以通过聚集的球机和盒式摄像机或强大的跟踪算法轻松获得同一车辆的多视角图像。
- 另一方面,我们可以通过关联相应的跨场景轨迹来获得同一车辆的跨场景多视图图像。除了上述智能采集之外,我们还可以在监控系统中手动构造多视图查询图像。
面临的挑战:克服不同视点引起的剧烈外观变化,有效地整合多查询图像场景(或随机视点缺失)之间的互补信息,从而学习某种车辆更全面的外观特征表示
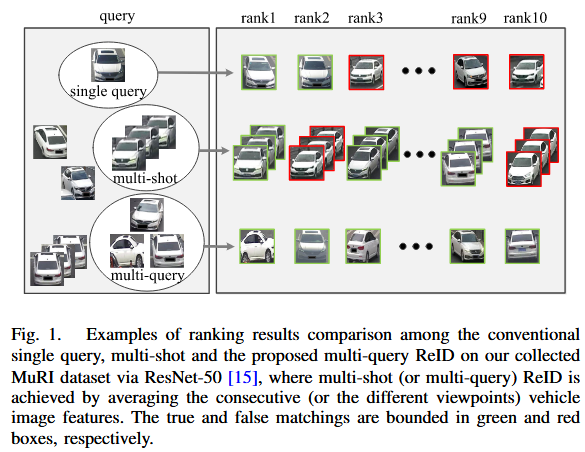
【图1】目的是比较这三种不同设置下(单查询、多拍摄、多查询)ReID的性能,强调多查询ReID方法的优势,即通过结合来自不同视角的多个查询图像,可以显著提高识别的准确性和鲁棒性。这种设置更贴近实际监控场景中的情况,因为在现实世界中,可以通过多个摄像头从不同视角捕获同一辆车的图像。
1 | title: 单查询、多拍摄、多查询ReID |
这种方法旨在通过利用多个查询图像来克服单一查询视角的局限性,从而提高车辆重识别的性能。
方法简介:
首先,在训练过程中,为了充分利用车辆的多样化视点信息,我们提出了视点条件编码(VCC)模块,它将学习到的车辆视点特征作为视点条件编码信息,并将其集成到对车辆外观的特征学习过程中。
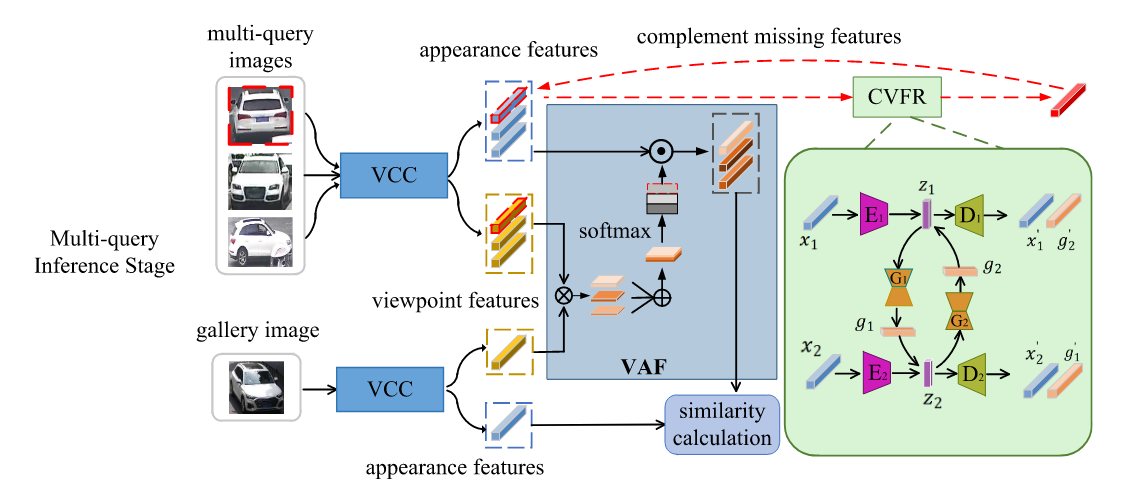
其次,我们提出了基于视点的自适应融合(VAF)模块,在多查询推理过程中自适应地融合车辆的视点编码外观特征。特别的,它自适应地为外观特征分配权重根据与gallery集的视点相似度进行多个查询。查询图像与当前图库图像之间的视点相似度越高,对应查询图像的外观特征的权重就越大。
最后,为了容忍推理中查询集中缺失的视点,我们提出了一种跨视图特征恢复模块(CVFR) 来恢复缺失视点的特征。跨视图特征恢复模块通过最大化不同视点特征的公共信息来学习多个视点的一致性,并通过最小化来实现跨视图特征的可恢复性
跨视图特征恢复模块通过最大化不同视点特征的公共信息来学习多个视点的一致性,并通过最小化不同视点特征之间的条件熵来实现跨视图特征的可恢复性。
本文提出的测试指标称为跨场景精度均值(mean Cross-scene Precision, mCSP)。这个指标是为了解决现有车辆重识别(Re-ID)评估指标忽视跨场景检索能力的局限性而设计的。现有的指标,如CMC(Cumulative Matching Characteristics)、mAP(mean Average Precision)和mINP(mean Inter-personal Precision),虽然广泛使用,但它们主要关注查询和库之间的全局关系,而忽略了库内部的局部关系。
现有的指标在处理来自同一摄像头的正样本时,如果这些样本的视角相似,往往会导致虚高的分数,因为这些样本更容易被匹配。这在现实世界的Re-ID应用中是不切实际的,因为理想的情况是模型能够跨不同摄像头(场景)准确地检索到目标车辆。
为了解决这个问题,mCSP指标的提出基于以下原则:
- 跨场景检索能力:mCSP通过抑制来自同一摄像头且视角相似的正样本,来衡量模型的跨场景检索能力。
- 去除相似视角的正样本:如果在排名列表中存在来自同一摄像头的正样本,并且它们的视角特征之间的欧几里得距离小于某个阈值,那么这些样本被视为来自同一场景,并在计算过程中被移除。
- 精度计算:在移除了具有相似视角的正样本后,mCSP计算的是考虑跨场景检索情况下的精度。
此外,文章还介绍了一个名为MuRI的新车辆图像数据集,该数据集由真实交通监控系统中的6142个摄像机拍摄,包含200个身份,涵盖了多种视角和大量的交叉场景,为多查询车辆重识别提供了更真实和具有挑战性的场景。
最后,文章提出了一个名为mCSP的新评估指标,用于衡量模型在跨场景检索中的能力,并通过对现有车辆重识别数据集的比较,展示了MuRI数据集的优势。
Method
网络结构
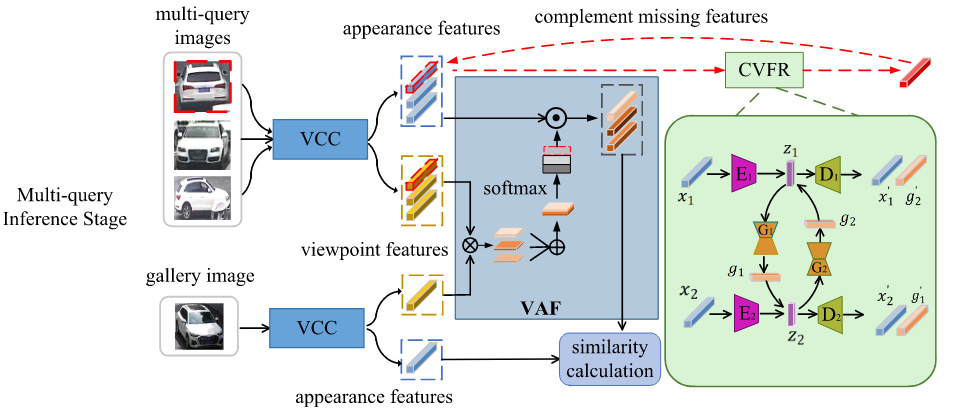
我们的 VCNet 包括两个阶段:多查询推理,如图 2 所示。首先,我们提出了一个视点条件编码(VCC)模块来学习特定的视点信息。通过对车辆视点特征进行编码并将其嵌入到车辆细节特征的学习过程中,强制模型关注车辆特定视点下的细节信息。
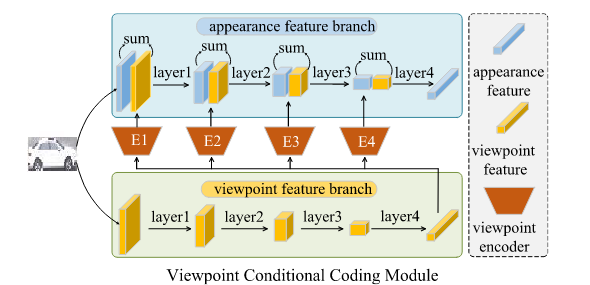
如图3所示,我们使用车辆的视点特征作为条件编码信息,与网络每一层获得的车辆细节特征进行融合。因此,它使模型能够关注车辆视点信息,同时学习该视点的判别特征。
为了整合车辆不同视点之间的互补信息,我们提出了一种用于多查询推理的基于视点的自适应融合(VAF)模块。如图2所示,我们首先根据多查询和图库视点特征之间的相似度分配查询的外观特征权重,然后根据获得的权重自适应地融合多查询的特征,从而考虑车辆不同视点特征之间的互补性和特殊性。
为了处理缺少视点的多查询图像的场景,我们进一步提出了一种跨视图特征恢复(CVFR)模块来恢复丢失的外观特征。 CVFR模块通过比较学习最大化不同视点之间的共同信息,并基于共同信息完成不同视点特征之间的重建。
VCC - 用于训练
由于不同视点而导致的较大类内差异性 对车辆重新识别来说是一个巨大的挑战。因此,对于不同视点的车辆,网络应该关注不同的细节区域。为了充分利用车辆视点信息,我们提出了视点条件编码(VCC)模块,如图3所示。我们在VCC模块中引入了双流网络结构,上下分支用于分别学习车辆的外观和视点特征,两个分支都使用 ResNet-50 作为特征提取器。
首先,与王等人不同【他们在VeRI-776数据集上标记8个视点(前、后、左、左前、左后、右、右前和右后】,我们将8个视点重新划分为3个视点标签(前、后、侧)最大化不同视点之间的差异,以进行视点预测的训练。为了获得更稳健和更精细的视点特征,在 VeRI-776 数据集上训练的基础上,我们在 MuRI 数据集上重新训练视点预测网络。我们使用交叉熵损失作为视角训练的监督,如下所示:
$$\mathcal{L}{view}=-\frac{1}{N}\sum{i=1}^{N}log(p(v_i|x_i)),$$
其中 N 表示训练批次中的图像数量,xi 表示输入图像,vi 表示视点标签。
然后,为了强制网络基于视点信息关注更具辨别力的区域,将学习到的视点特征编码到车辆外观特征学习分支。在这里,我们使用不同的反卷积函数作为视点编码器,将视点特征映射到与相应层维度相同的嵌入特征。接下来,我们将外观特征和嵌入特征相加,然后作为视点编码信息发送到网络的下一层。最后,我们可以获得包含特定视点信息的车辆特征。使用交叉熵损失和三元组损失来训练外观特征如下
$$\begin{aligned}\mathcal{L}{appearance}&=-\frac1N\sum{i=1}^Nlog(p(y_i|x_i))\&+\frac1N\sum_{i=1}^N(m+d(f_a^i,f_p^i)-d(f_a^i,f_n^i)),\end{aligned}$$
其中yi表示外观标签,m表示margin,d(·)表示欧氏距离,fa、fp和fn分别表示anchor、正外观特征和负外观特征
最后,VCC模块总的训练loss是:
$$ \mathcal{L}{vcc} = \mathcal{L}{view} + \mathcal{L}_{appearance}$$
![[Pasted image 20240923192207.png|400]]
为了证明VCC模块的有效性,我们将最后一层的特征可视化,如图4所示。VCC模块可以减少背景的干扰并强制模型更好地聚焦于车辆,对比图4(a2)同图4(a1)。此外,VCC模块鼓励模型专注于分类的主要线索,并探索更多的判别区域,将图4(b2)和(c2)与图4(b1)和(c1)进行比较。
VAF - 用于推理
虽然我们在 VCC 模块中获得了包含视点信息的强大功能,但其中的有限信息单个查询图像极大地阻碍了车辆重识别在推理阶段的性能。为了在推理阶段整合车辆的多视点信息并解决查询和图库之间不同视点的差距,我们在推理过程中提出了基于视点的自适应融合(VAF)模块,该模块自适应地将生成的视点权重与外观特征融合。推理过程如图2所示。
首先,我们联合使用查询集中具有不同视点的3张车辆图像,并将它们发送到预训练的VCC模块中,分别提取外观特征和视点特征。为了获得3个查询图像与图库图像之间的视点相似度,我们计算3个查询视点特征与图库视点特征之间的特征余弦距离,如下所示,
$$s_i=\frac{<f_v^{q_i}, f_v^g>}{||f_v^{q_i}||\times||f_v^g||}$$
i 是1,2,3,就是我们选择的3张车辆图像;
$f_v^{q_i}$ 是 query 集的特征;$f_v^g$ 是 gallery 集的特征;分子是他俩做内积 inner product
然后,我们可以通过使用级联和softmax函数计算查询和图库视点特征的相似度来获得相似度权重集$W = {w_{i}|i=1,2,3}$。为了自适应地融合外观特征中的视点信息,我们将多查询外观特征 $F = { f_{a}^{q_{i}} |i = 1, 2, 3 }$ 与相似权重集 W 相乘,以获得加权外观特征 F′,如下所示:
$$
\bar{F}=\left{f_{a}^{\bar{q}{1}}\times w{1},\bar{f_{a}^{q_{1}}}\times w_{2},\bar{f_{a}^{q_{1}}}\times w_{3}\right},
$$
为此,与图库图像具有相似视点的查询外观特征将被分配较大的权重。如果随机视点的查询图像丢失,则外观特征将由跨视图特征恢复(CVFR)模块恢复。对于最终的识别任务,我们将融合的外观特征与图库外观特征之间进行相似度计算,并获得相应的分数,将这些分数相加得到最终的识别分数。
CVFR - 用于推理
在某些场景下,查询数据可能不包含车辆图像的某些视点。虽然我们的网络接受三个查询车辆图像作为输入,因此无法处理缺少视点的此类数据。 为了解决这个问题,在多视图中,我们提出了跨视图特征恢复(CVFR)模块来恢复丢失的外观特征。为了学习信息丰富的一致表示,CVFR模块通过对比学习最大化不同观点之间的互信息。为了恢复丢失的外观特征,CVFR模块通过对偶预测最小化不同视点的条件熵。为了方便起见,我们==假设随机缺失前、后、侧面一个视点==,缺失外观特征的恢复过程如下:
1 | title: dual prediction 对偶预测是啥玩意?? |
首先,我们将来自不同视点的两张已知图像发送到预训练的VCC模块并获得外观特征 x1 和 x2
然后,在各个编码器E1、E2之后获得潜在表示Z1、Z2,并且在解码器D1、D2之后获得重建特征x’1、x’2。重建的差异将通过均方误差损失函数最小化,如下所示
$$\mathcal{L}{mse}=\sum{v=1}^2\sum_{t=1}^m||x_v^t-x_v^{\prime t}||^2,$$
其中 xtv 表示 xv 的第 t 个样本。为了提高数据恢复能力,使用对比学习来学习不同观点之间的共同信息并最大化共同信息。对比损失数学公式如下:
$$\mathcal{L}{cl}=-\sum{t=1}^m(I(Z_1^t,Z_2^t)+\alpha(H(Z_1^t)+H(Z_2^t)))$$
其中 I 表示互信息,H是信息熵,在我们的实验中将参数α设置为9以正则化熵。从信息论来看,信息熵是一个事件传达的平均信息量。因此,较大的熵 H (Zi ) 表示包含更多信息的表示 Zi 。视点预测器 G1、G2 用于生成相应视点的潜在表示,并通过最小化损失函数来生成差异,
$$\mathcal{L}{pre}=\sum{v=1}^2\sum_{t=1}^m||g_v^t-Z_{3-v}^t||^2$$
其中v表示可用视点的数量,我们可以从可用视点中获得随机视点缺失的外观特征。
为了进一步缩小生成的视点特征和原始视点特征之间的差异,我们将视点预测器生成的潜在表示分别输入到相应的解码器中。然后我们得到重构特征 g′ 1, g′ 2 的生成,它们受到均方误差损失的约束,
$$\mathcal{L}{mse}=\sum{v=1}^2\sum_{t=1}^m||x_v^t-D_v(g_k^t)||^2,$$
其中 Dv 表示解码器。因此,即使采用传统的单一查询设置,我们的框架仍然可以通过集成给定特征和恢复特征之间的互补信息来学习特定车辆的更全面的外观特征表示,这有望显著克服不同视点引起的剧烈外观变化。
MURI Dataset
为了评估所提出的多查询车辆重识别的 VCNet,我们提出了一个多视图和无约束的车辆重识别数据集 MuRI,以在推理过程中集成不同视点之间的互补信息。
获取
MuRI 数据集是在一个面积超过 1000 平方公里的大城市收集的。为了获取更多样摄像头的车辆图像,我们首先在公安城市服务平台中按车牌搜索对应的车辆图像,该平台监控全市数万个摄像头。为了保证每辆车都有丰富的视点信息,我们在一个交通路口获取不同视点的车辆图像,该路口有来自不同方向的三到四个监控摄像头。如图5所示,为了保证视点信息的多样性,我们选择公安城市服务平台的可旋转球型摄像机作为拍摄摄像机。对于从平台捕获的视频,我们通过跟踪检测算法生成周围的框。为了有效评估,我们自动选择每3个相邻帧中的车辆图像,然后进行手动检查以避免数据冗余。数据集中车辆出现的时间跨度约为半年,并且由于摄像机和感兴趣车辆之间的距离不同,车辆分辨率也是可变的。
介绍
MuRI 数据集包含 5 个视点(前、侧前、侧、后和侧后)的 200 个身份,具有不同的分辨率和照明条件。由于正面和侧面以及背面和侧面背面的外观相似,因此本文将这五个视点合并为三个,即正面、侧面和背面。为了有效评估,我们在每3张相邻图像中自动选择交通路口的车辆图像,然后进行人工检查以避免数据冗余。包括从公安城市服务平台采集的图像我们的 MuRI 总共由 6142 个摄像头形成 23637 个车辆图像,通过海量摄像头进行多查询车辆 Re-ID 提供更接近现实的智慧城市场景。我们选择 150 个身份进行训练,选择 50 个身份进行测试/推理。 在推理阶段,我们使用整个测试集作为图库集,同时从不同的角度随机选择3条记录作为多查询图像。
挑战
我们的 MuRI 主要包含五个不同的挑战,如图 6 所示。首先,我们的数据集提供了全面的五个视点,包括每辆车的前部(side front)、侧部和后部(side rear),这产生了巨大的内部车辆重新识别类。然后,由于摄像机和感兴趣的车辆之间的距离不同,车辆图像呈现出不同的分辨率,如图6(b)所示。低分辨率下的详细信息较差以及不同分辨率之间的外观差距进一步给车辆Re-ID带来巨大的挑战。而且,MuRI数据集是在跨度超过1000平方公里的大型城市监控系统中收集的,城市环境非常复杂。为此,MuRI包含许多具有遮挡和复杂背景的车辆图像,如图6(c,d)所示,这给车辆Re-ID带来了严峻的挑战。最后,MuRI数据集中的车辆图像是在半年以上的较长时间跨度内收集的,提供了大量跨时间不同光照的车辆数据,例如早上、下午和晚上,如图6所示(e).较大的光照变化导致车辆外观差异巨大。此外,夜间前灯和尾灯的强烈照明给车辆重新识别带来了额外的挑战。
特征
与表1所示的现有流行的Re-ID数据集相比,在计算平均视点数时数据集中的每个id,我们根据前部、侧部前部、侧部、侧部后部和后部将车辆视点分为五类。 MuRI具有以下主要优点。
1)摄像机数量多,范围广。 MuRI 包含由 6142 个摄像头从覆盖超过 1000 平方公里城市区域的现实交通监控系统捕获的 200 个车辆 ID。
2)综合各ID的观点。 MuRI为每辆车提供了全面的五个视点,包括前(side front)、侧(side)和后(side rear),这为车辆Re-ID提供了更加真实和具有挑战性的场景。
3)每个ID经过的摄像机数量较多。 MuRI中的每辆车平均经过34.6个摄像头,从30个到50个摄像头不等,如图7所示。
MCSP 评估标准
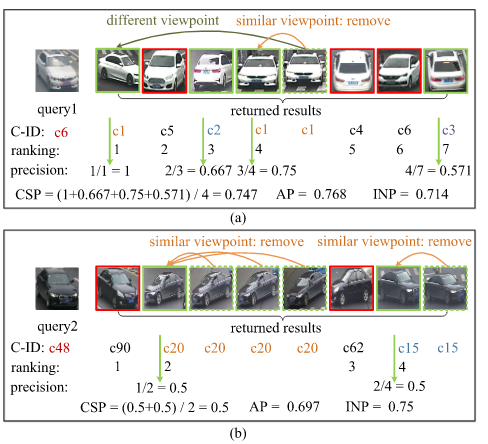
现有指标的一个问题是缺乏跨场景场景的考虑。为此,本文提出了一种新的度量,称为平均跨场景精度(mCSP),以保证网络的跨场景检索能力。 mCSP的主要思想可以概括为:如果存在来自同一相机的具有相似视点的正样本,我们将它们视为同一场景并将它们从排序列表中删除。
给定一个排序列表,我们用 TP 表示检索到的正样本的数量,$f^i_{c}$ 和 $f^j_{c}$ 表示在同一摄像机 c 下检索到的两个正样本图像的视点特征。
当它们的欧氏距离小于阈值超参数 $\epsilon$ 时,我们认为 $f^i_{c}$ 和 $f^j_{c}$ 是相似的。我们用 SC 表示 TP 中同一相机 ID 下具有相似视点的样本数量,FP 表示有预测误差的正样本数量,mCSP 可以表示为以下形式
$$mCSP=\frac{\sum_{i=0}^{N_{cs}}\frac{TP-SC}{TP-SC+FP}}{N_{cs}},$$
其中$N_{cs}$表示使用不同相机从正样本中捕获的目标图像。我们可视化CSP的计算过程,如图8所示。如图 8a 所示,即使传统的Re-ID指标(例如AP和INP)删除了车辆图像,与图库集中的查询相同的相机,在另一个相同相机(与查询相机不同)下具有相似视点的正样本仍然更容易被识别,这导致现有指标的得分几乎很高。相比之下,对于来自不同摄像机的查询的正样本,所提出的 CSP 度量进一步删除了来自另一个相同摄像机的具有相似视点的样本。因此,通过进一步抑制具有相似视点的正样本,可以更好地反映跨摄像机检索的能力,如图 8b 所示。
Experiments
实验设置
1)训练:我们使用在 ImageNet上预训练的 ResNet-50 作为我们的主干。该模型使用 SGD 优化器训练了 80 个 epoch。我们在前 5 个 epoch 中将学习率预热到 5e-2,并且骨干网在预热步骤中被冻结。 5e-2的学习率保持到第60个,在第60个epoch下降到5e-3,再下降到5e-4 在第 75 个时期,以实现更快的收敛。
我们首先在图像边框上填充 10 个像素,然后随机将其裁剪为 256×256。我们还通过随机擦除来增强数据。
此外,我们在全局特征之后添加了一个 Batch Normalization 层。添加全连接层以将全局特征映射到 ID 分类分数。 MuRI 数据集中的批量大小为 36。
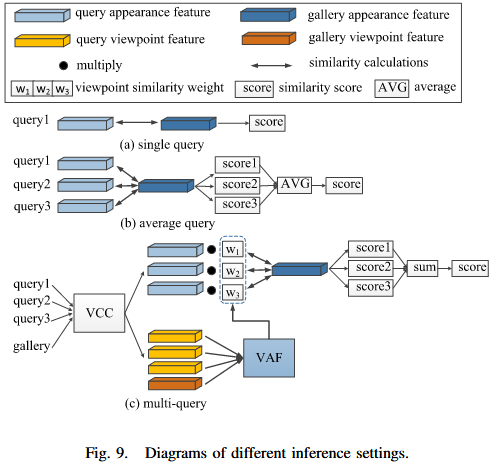
2)推理:在推理过程中,我们以三种推理方式评估方法,包括单查询、平均查询和多查询。
如图9(a)所示,单次推理直接计算每个查询与图库集之间的余弦距离,忽略了推理过程中的多视图信息。
当面对多个查询时,直观的推理方式是平均推理,即计算多个查询特征的平均值,如图9(b)所示。
然而,简单地对查询特征进行平均并不能有效地利用车辆的不同视点信息。为了自适应地利用来自具有不同视点组合的不同摄像机的多个查询中的互补信息,我们提出了针对所提出的 VCNet 的多重推理,如图 9(c)所示。
具体来说,它通过多个查询和图库视图特征之间的相似性生成视点权重,然后将生成的视点权重与外观特征融合。为了证明所提出的多查询设置相对于以前的单查询或平均查询设置的显着优势,我们展示了不同设置的排名结果,如图10所示。与单查询和平均查询相比,多查询可以达到较早的正样本,因为它可以打破信息壁垒,通过结合不同视角的车辆信息来获得车辆的整体特征。