Redis 单机安装Redis
Redis下载地址 https://redis.io/download/
安装之前首先要保证环境中有安装Redis所需要的gcc依赖
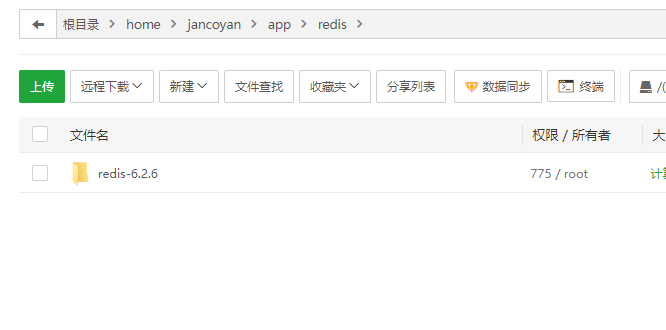
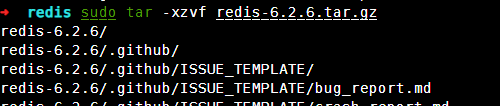
上传安装包并解压
这里使用宝塔Linux面板进行上传
1 redis sudo tar -xzvf redis-6.2.6.tar.gz
进入目录并编译
1
2
3
cd redis-6.2.6sudo make && make install
默认的安装路径是在 /usr/local/bin目录下:
该目录以及默认配置到环境变量,因此可以在任意目录下运行这些命令。其中:
redis-cli:是redis提供的命令行客户端
redis-server:是redis的服务端启动脚本
redis-sentinel:是redis的哨兵启动脚本
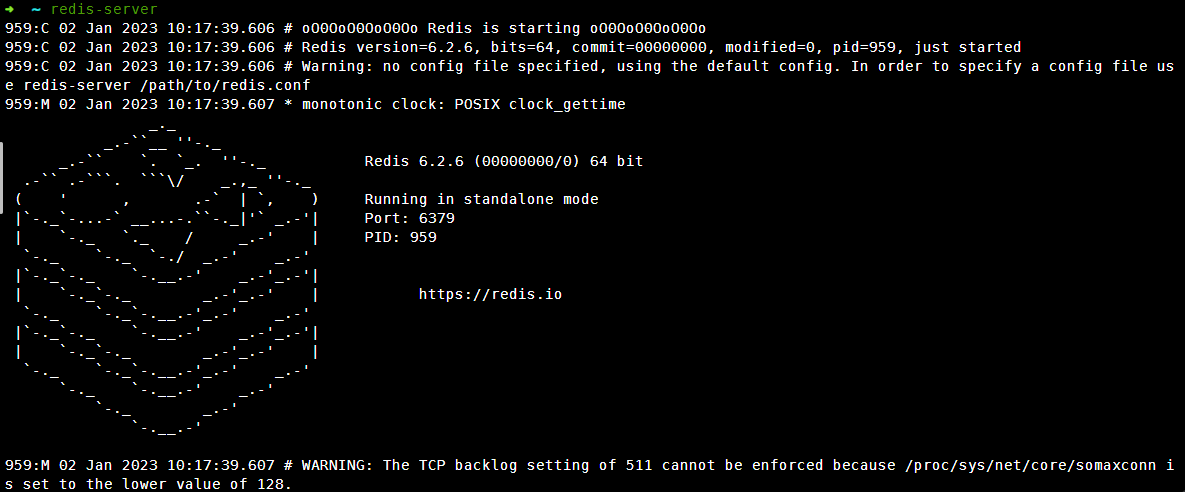
启动 redis的启动方式有很多种,例如:
默认启动 任意位置输入命令
这种启动属于前台启动,会阻塞整个会话窗口,窗口关闭或者按下CTRL + C则Redis停止。不推荐使用。
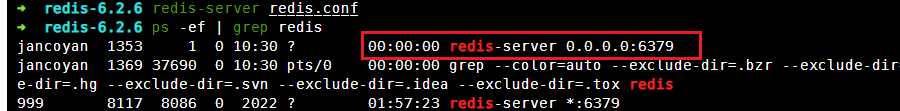
指定配置启动 如果要让Redis以后台方式启动,则必须修改Redis配置文件,就在我们之前解压的redis安装包下(/usr/local/src/redis-6.2.6),名字叫redis.conf:
我们先将这个配置文件备份一份:
1 sudo cp redis.conf redis.conf.bak
然后修改redis.conf文件中的一些配置:
1
2
3
4
5
6
7
8
9
10
11
12
# 允许访问的地址,默认是127.0.0.1,会导致只能在本地访问。修改为0.0.0.0则可以在任意IP访问,生产环境不要设置为0.0.0.0 # 在文件的第75行 bind 0.0.0.0 # 守护进程,修改为yes后即可后台运行 # 在文件的第257行 daemonize yes # 密码,设置后访问Redis必须输入密码 # 在文件的第901行 requirepass 333
Redis的其它常见配置:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 监听的端口 port 6379 # 工作目录,默认是当前目录,也就是运行redis-server时的命令,日志、持久化等文件会保存在这个目录 dir . # 数据库数量,设置为1,代表只使用1个库,默认有16个库,编号0~15 databases 1 # 设置redis能够使用的最大内存 maxmemory 512mb # 日志文件,默认为空,不记录日志,可以指定日志文件名 logfile "redis.log"
启动Redis:
1
2
3
4
5
# 进入redis安装目录 cd /usr/local/src/redis-6.2.6 # 启动 redis-server redis.conf
停止服务
找到进程直接kill即可。
设置开机自启
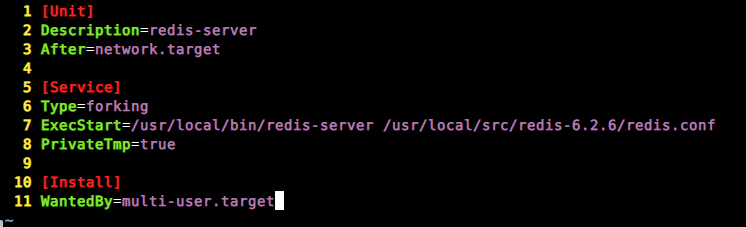
新建一个系统服务文件
1 sudo vim /etc/systemd/system/redis.service
内容如下:
1
2
3
4
5
6
7
8
9
10
11
[Unit] Description=redis-server After=network.target [Service] Type=forking ExecStart=/usr/local/bin/redis-server /usr/local/src/redis-6.2.6/redis.conf PrivateTmp=true [Install] WantedBy=multi-user.target
重载系统服务
1 sudo systemctl daemon-reload
使用以下命令操作redis
1 2 3 4 5 6 7 8 systemctl start redis systemctl stop redis systemctl restart redis systemctl status redis
执行下面的命令,可以让redis开机自启:
Redis客户端 安装完成Redis,我们就可以操作Redis,实现数据的CRUD了。这需要用到Redis客户端,包括:
命令行客户端 Redis安装完成后就自带了命令行客户端:redis-cli,使用方式如下
1 redis-cli [options] [commonds]
其中常见的options有:
-h 127.0.0.1:指定要连接的redis节点的IP地址,默认是127.0.0.1-p 6379:指定要连接的redis节点的端口,默认是6379`-a 333:指定redis的访问密码
其中的commonds就是Redis的操作命令,例如:
ping:与redis服务端做心跳测试,服务端正常会返回pong
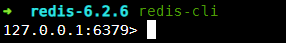
不指定commond时,会进入redis-cli的交互控制台:
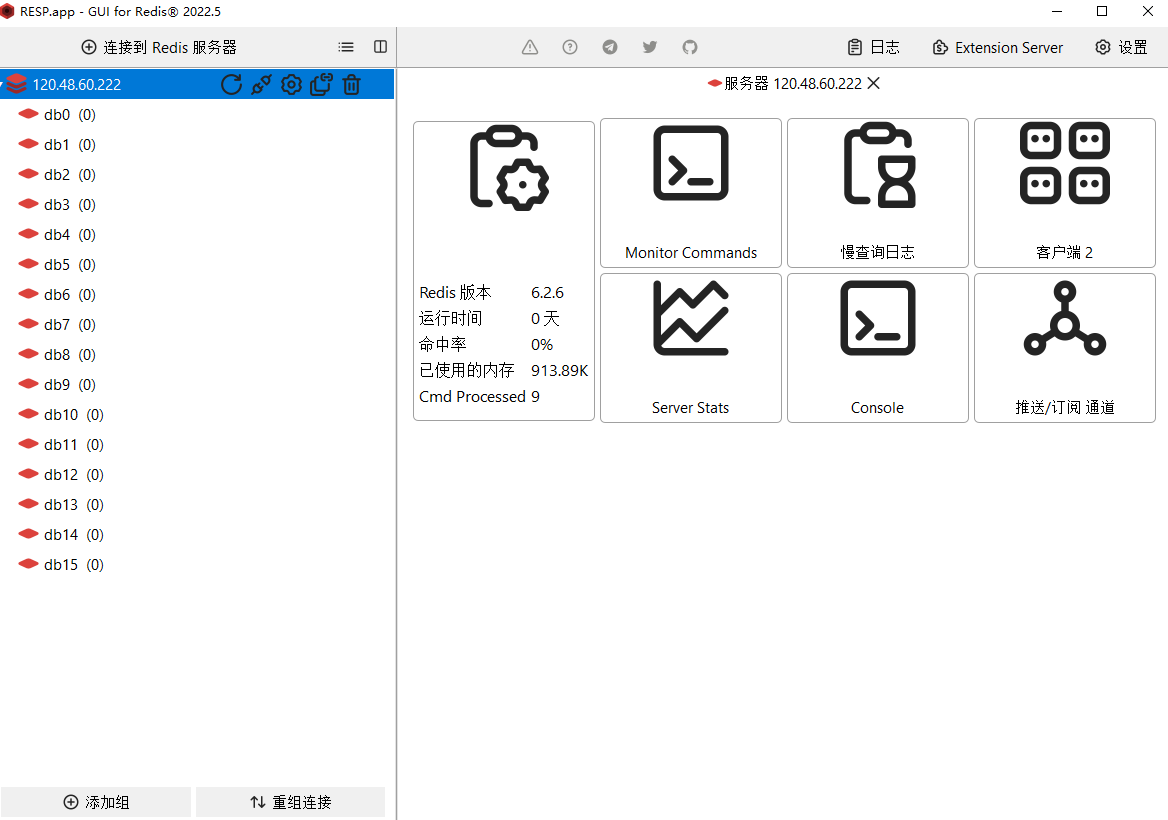
图形化桌面客户端RDM 在下面这个仓库可以找到安装包:https://github.com/lework/RedisDesktopManager-Windows/releases
安装运行即可,基本不需要配置。
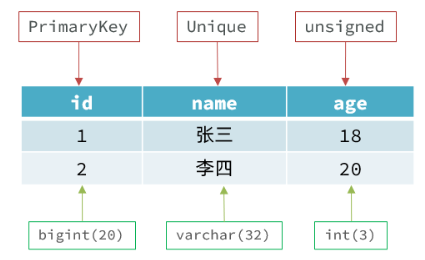
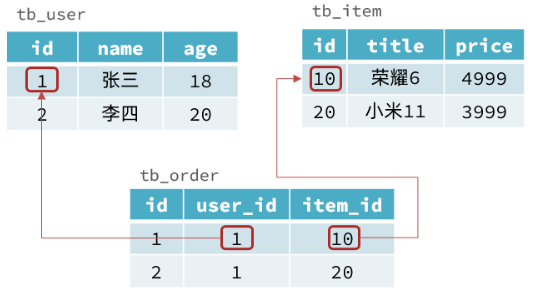
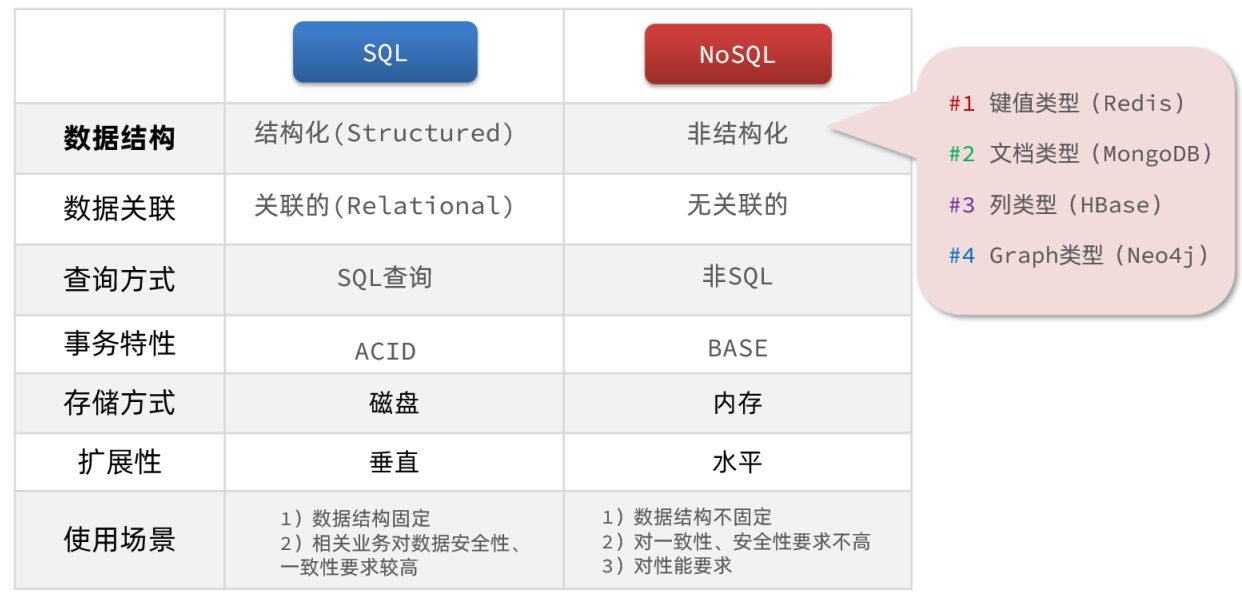
NoSQL 结构化与非结构化 传统关系型数据库是结构化数据,每一张表都有严格的约束信息:字段名.字段数据类型.字段约束等等信息,插入的数据必须遵守这些约束。
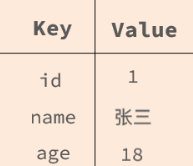
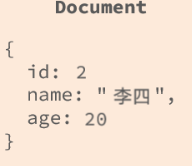
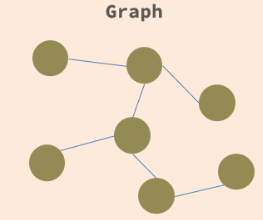
而NoSql则对数据库格式没有严格约束,往往形式松散,自由。可以是键值型、也可以是文档型、甚至可以是图格式
关联和非关联 传统数据库的表与表之间往往存在关联,例如外键
非关系型数据库不存在关联关系,要维护关系要么靠代码中的业务逻辑 ,要么靠数据之间的耦合
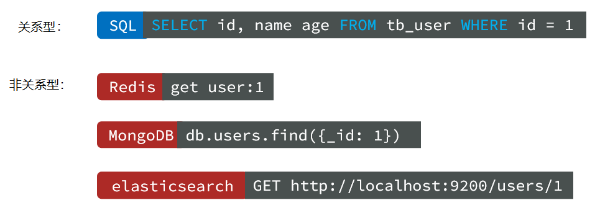
查询方式 传统关系型数据库会基于Sql语句做查询,语法有统一标准
而不同的非关系数据库查询语法差异极大,五花八门各种各样
事务 传统关系型数据库能满足事务ACID的原则,而非关系型数据库往往不支持事务,或者不能严格保证ACID的特性,只能实现基本的一致性。
存储方式
关系型数据库基于磁盘进行存储,会有大量的磁盘IO,对性能有一定影响
非关系型数据库,他们的操作更多的是依赖于内存来操作,内存的读写速度会非常快,性能自然会好一些
扩展性
关系型数据库集群模式一般是主从,主从数据一致,起到数据备份的作用,称为垂直扩展。
非关系型数据库可以将数据拆分,存储在不同机器上,可以保存海量数据,解决内存大小有限的问题。称为水平扩展。
关系型数据库因为表之间存在关联关系,如果做水平扩展会给数据查询带来很多麻烦
概述 认识Redis Redis诞生于2009年全称是Re mote D ictionary S erver 远程词典服务器,是一个基于内存的键值型NoSQL数据库。
特征 :
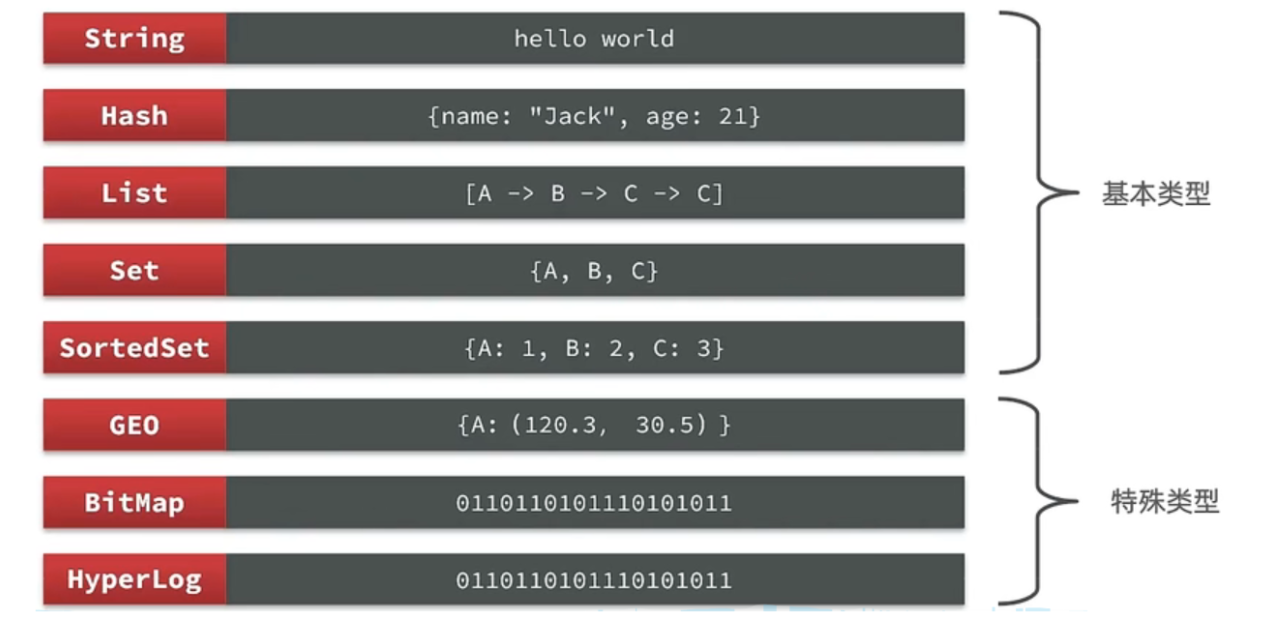
键值(key-value)型,value支持多种不同数据结构,功能丰富
单线程,每个命令具备原子性
低延迟,速度快(基于内存.IO多路复用.良好的编码)。
支持数据持久化
支持主从集群.分片集群
支持多语言客户端
作者 :Antirez
Redis的官方网站地址:https://redis.io/
安装 [[redis-install]]
常用命令 常见命令可以在官网 查询
也可以在终端使用help命令进行查询
1
2
3
4
5
6
7
8
9
10
11
12
127.0.0.1:6379> help redis-cli 6.2.6 To get help about Redis commands type : "help @<group>" to get a list of commands in <group> "help <command>" for help on <command > "help <tab>" to get a list of possible help topics "quit" to exit To set redis-cli preferences: ":set hints" enable online hints ":set nohints" disable online hints Set your preferences in ~/.redisclirc
通用命令 通用指令是部分数据类型的,都可以使用的指令,常见的有:
KEYS:查看符合模板的所有key
DEL:删除一个指定的key
EXISTS:判断key是否存在
EXPIRE:给一个key设置有效期,有效期到期时该key会被自动删除
TTL:查看一个KEY的剩余有效期
String命令 String类型,也就是字符串类型,是Redis中最简单的存储类型。
其value是字符串,不过根据字符串的格式不同,又可以分为3类:
string:普通字符串
int:整数类型,可以做自增.自减操作
float:浮点类型,可以做自增.自减操作
String的常见命令有:
SET:添加或者修改已经存在的一个String类型的键值对
GET:根据key获取String类型的value
MSET:批量添加多个String类型的键值对
MGET:根据多个key获取多个String类型的value
INCR:让一个整型的key自增1
INCRBY:让一个整型的key自增并指定步长,例如:incrby num 2 让num值自增2
INCRBYFLOAT:让一个浮点类型的数字自增并指定步长
SETNX:添加一个String类型的键值对,前提是这个key不存在,否则不执行
SETEX:添加一个String类型的键值对,并且指定有效期
[!note]
SET 和GET: 如果key不存在则是新增,如果存在则是修改
1
2
3
4
5
6
7
8
127.0.0.1:6379> set name jancoyan // 原来不存在就是添加 OK 127.0.0.1:6379> get name "jancoyan" 127.0.0.1:6379> set name janco // 原来存在就是修改 OK 127.0.0.1:6379> get name "janco"
1
2
3
4
5
6
7
127.0.0.1:6379> mset k1 v1 k2 v2 k3 v3 // 批量设置 OK 127.0.0.1:6379> mget name k1 k2 k3 // 批量获取 1) "janco" 2) "v1" 3) "v2" 4) "v3"
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
127.0.0.1:6379> get age "10" 127.0.0.1:6379> incr age //增加1 (integer ) 11 127.0.0.1:6379> get age //获得age "11" 127.0.0.1:6379> incrby age 2 //一次增加2 (integer ) 13 //返回目前的age的值 127.0.0.1:6379> incrby age 2 (integer ) 15 127.0.0.1:6379> incrby age -1 //也可以增加负数,相当于减 (integer ) 14 127.0.0.1:6379> incrby age -2 //一次减少2个 (integer ) 12 127.0.0.1:6379> DECR age //相当于 incr 负数,减少正常用法 (integer ) 11 127.0.0.1:6379> get age "11"
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
127.0.0.1:6379> help setnx SETNX key value summary: Set the value of a key, only if the key does not exist since: 1.0.0 group: string 127.0.0.1:6379> set name Jack //设置名称 OK 127.0.0.1:6379> setnx name lisi //如果key不存在,则添加成功 (integer ) 0 127.0.0.1:6379> get name //由于name已经存在,所以lisi的操作失败 "Jack" 127.0.0.1:6379> setnx name2 lisi //name2 不存在,所以操作成功 (integer ) 1 127.0.0.1:6379> get name2 "lisi"
1
2
3
4
5
6
7
8
127.0.0.1:6379> setex name 10 jack OK 127.0.0.1:6379> ttl name (integer ) 8 127.0.0.1:6379> ttl name (integer ) 7 127.0.0.1:6379> ttl name (integer ) 5
Key的层级结构 Redis没有类似MySQL中的Table的概念,我们该如何区分不同类型的key呢?
例如,需要存储用户.商品信息到redis,有一个用户id是1,有一个商品id恰好也是1,此时如果使用id作为key,那就会冲突了,该怎么办?
我们可以通过给key添加前缀加以区分,不过这个前缀不是随便加的,有一定的规范:
Redis的key允许有多个单词形成层级结构,多个单词之间用’:’隔开,格式如下:
这个格式并非固定,也可以根据自己的需求来删除或添加词条。
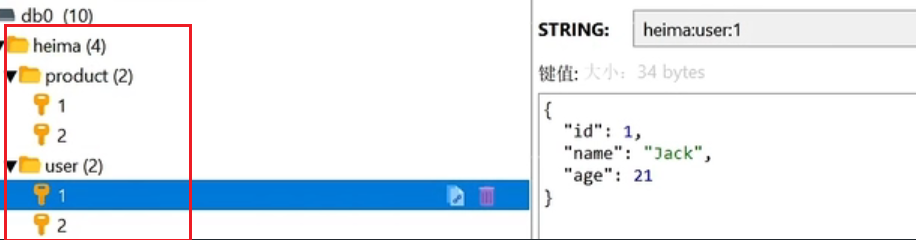
例如我们的项目名称叫 heima,有user和product两种不同类型的数据,我们可以这样定义key:
user相关的key:heima:user:1
product相关的key:heima:product:1
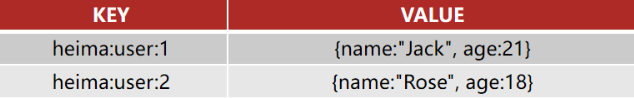
如果Value是一个Java对象,例如一个User对象,则可以将对象序列化为JSON字符串后存储:
KEY VALUE
heima:user:1
{“id”:1, “name”: “Jack”, “age”: 21}
heima:product:1
{“id”:1, “name”: “小米11”, “price”: 4999}
一旦我们向redis采用这样的方式存储,那么在可视化界面中,redis会以层级结构来进行存储,形成类似于这样的结构,更加方便Redis获取数据
Hash命令 Hash类型,也叫散列,其value是一个无序字典,类似于Java中的HashMap结构。
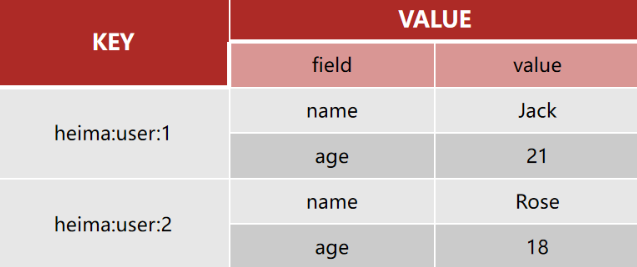
String结构是将对象序列化为JSON字符串后存储,当需要修改对象某个字段时很不方便
Hash结构可以将对象中的每个字段独立存储,可以针对单个字段做CRUD
Hash类型的常见命令
HSET key field value:添加或者修改hash类型key的field的值
HGET key field:获取一个hash类型key的field的值
HMSET:批量添加多个hash类型key的field的值
HMGET:批量获取多个hash类型key的field的值
HGETALL:获取一个hash类型的key中的所有的field和value
HKEYS:获取一个hash类型的key中的所有的field
HINCRBY:让一个hash类型key的字段值自增并指定步长
HSETNX:添加一个hash类型的key的field值,前提是这个field不存在,否则不执行
HSET和HGET
1
2
3
4
5
6
7
8
9
10
127.0.0.1:6379> HSET heima:user:3 name Lucy//大key是 heima:user:3 小key是name,小value是Lucy (integer ) 1 127.0.0.1:6379> HSET heima:user:3 age 21// 如果操作不存在的数据,则是新增 (integer ) 1 127.0.0.1:6379> HSET heima:user:3 age 17 //如果操作存在的数据,则是修改 (integer ) 0 127.0.0.1:6379> HGET heima:user:3 name "Lucy" 127.0.0.1:6379> HGET heima:user:3 age "17"
1
2
3
4
5
6
7
8
127.0.0.1:6379> HMSET heima:user:4 name HanMeiMei OK 127.0.0.1:6379> HMSET heima:user:4 name LiLei age 20 sex man OK 127.0.0.1:6379> HMGET heima:user:4 name age sex 1) "LiLei" 2) "20" 3) "man"
1
2
3
4
5
6
7
127.0.0.1:6379> HGETALL heima:user:4 1) "name" 2) "LiLei" 3) "age" 4) "20" 5) "sex" 6) "man"
1
2
3
4
5
6
7
8
127.0.0.1:6379> HKEYS heima:user:4 1) "name" 2) "age" 3) "sex" 127.0.0.1:6379> HVALS heima:user:4 1) "LiLei" 2) "20" 3) "man"
1
2
3
4
5
6
7
8
127.0.0.1:6379> HINCRBY heima:user:4 age 2 (integer ) 22 127.0.0.1:6379> HVALS heima:user:4 1) "LiLei" 2) "22" 3) "man" 127.0.0.1:6379> HINCRBY heima:user:4 age -2 (integer ) 20
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
127.0.0.1:6379> HSETNX heima:user4 sex woman (integer ) 1 127.0.0.1:6379> HGETALL heima:user:3 1) "name" 2) "Lucy" 3) "age" 4) "17" 127.0.0.1:6379> HSETNX heima:user:3 sex woman (integer ) 1 127.0.0.1:6379> HGETALL heima:user:3 1) "name" 2) "Lucy" 3) "age" 4) "17" 5) "sex" 6) "woman"
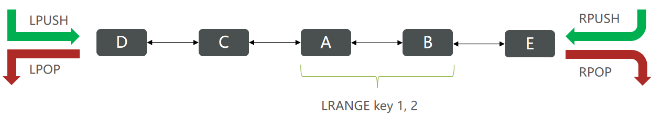
List命令 Redis中的List类型与Java中的LinkedList类似,可以看做是一个双向链表结构。既可以支持正向检索和也可以支持反向检索。
特征也与LinkedList类似:
常用来存储一个有序数据,例如:朋友圈点赞列表,评论列表等。
List的常见命令有:
LPUSH key element … :向列表左侧插入一个或多个元素
LPOP key:移除并返回列表左侧的第一个元素,没有则返回nil
RPUSH key element … :向列表右侧插入一个或多个元素
RPOP key:移除并返回列表右侧的第一个元素
LRANGE key star end:返回一段角标范围内的所有元素
BLPOP和BRPOP:与LPOP和RPOP类似,只不过在没有元素时等待指定时间,而不是直接返回nil
1
2
3
4
127.0.0.1:6379> LPUSH users 1 2 3 (integer ) 3 127.0.0.1:6379> RPUSH users 4 5 6 (integer ) 6
1
2
3
4
127.0.0.1:6379> LPOP users "3" 127.0.0.1:6379> RPOP users "6"
1
2
3
127.0.0.1:6379> LRANGE users 1 2 1) "1" 2) "4"
Set命令 Redis的Set结构与Java中的HashSet类似,可以看做是一个value为null的HashMap。因为也是一个hash表,因此具备与HashSet类似的特征:
无序
元素不可重复
查找快
支持交集.并集.差集等功能
Set类型的常见命令
SADD key member … :向set中添加一个或多个元素
SREM key member … : 移除set中的指定元素
SCARD key: 返回set中元素的个数
SISMEMBER key member:判断一个元素是否存在于set中
SMEMBERS:获取set中的所有元素
SINTER key1 key2 … :求key1与key2的交集
SDIFF key1 key2 … :求key1与key2的差集
SUNION key1 key2 ..:求key1和key2的并集
1
2
3
4
5
6
7
8
9
10
11
12
13
14
127.0.0.1:6379> sadd s1 a b c (integer ) 3 127.0.0.1:6379> smembers s1 1) "c" 2) "b" 3) "a" 127.0.0.1:6379> srem s1 a (integer ) 1 127.0.0.1:6379> SISMEMBER s1 a (integer ) 0 127.0.0.1:6379> SISMEMBER s1 b (integer ) 1 127.0.0.1:6379> SCARD s1 (integer ) 2
案例
将下列数据用Redis的Set集合来存储:
张三的好友有:李四.王五.赵六
李四的好友有:王五.麻子.二狗
利用Set的命令实现下列功能:
计算张三的好友有几人
计算张三和李四有哪些共同好友
查询哪些人是张三的好友却不是李四的好友
查询张三和李四的好友总共有哪些人
判断李四是否是张三的好友
判断张三是否是李四的好友
将李四从张三的好友列表中移除
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
127.0.0.1:6379> SADD zs lisi wangwu zhaoliu (integer ) 3 127.0.0.1:6379> SADD ls wangwu mazi ergou (integer ) 3 127.0.0.1:6379> SCARD zs (integer ) 3 127.0.0.1:6379> SINTER zs ls 1) "wangwu" 127.0.0.1:6379> SDIFF zs ls 1) "zhaoliu" 2) "lisi" 127.0.0.1:6379> SUNION zs ls 1) "wangwu" 2) "zhaoliu" 3) "lisi" 4) "mazi" 5) "ergou" 127.0.0.1:6379> SISMEMBER zs lisi (integer ) 1 127.0.0.1:6379> SISMEMBER ls zhangsan (integer ) 0 127.0.0.1:6379> SREM zs lisi (integer ) 1 127.0.0.1:6379> SMEMBERS zs 1) "zhaoliu" 2) "wangwu"
SortedSet类型 Redis的SortedSet是一个可排序的set集合,与Java中的TreeSet有些类似,但底层数据结构却差别很大。SortedSet中的每一个元素都带有一个score属性,可以基于score属性对元素排序,底层的实现是一个跳表(SkipList)加 hash表。
SortedSet具备下列特性:
因为SortedSet的可排序特性,经常被用来实现排行榜这样的功能。
SortedSet的常见命令有:
ZADD key score member:添加一个或多个元素到sorted set ,如果已经存在则更新其score值
ZREM key member:删除sorted set中的一个指定元素
ZSCORE key member : 获取sorted set中的指定元素的score值
ZRANK key member:获取sorted set 中的指定元素的排名
ZCARD key:获取sorted set中的元素个数
ZCOUNT key min max:统计score值在给定范围内的所有元素的个数
ZINCRBY key increment member:让sorted set中的指定元素自增,步长为指定的increment值
ZRANGE key min max:按照score排序后,获取指定排名范围内的元素
ZRANGEBYSCORE key min max:按照score排序后,获取指定score范围内的元素
ZDIFF.ZINTER.ZUNION:求差集.交集.并集
注意:所有的排名默认都是升序,如果要降序则在命令的Z后面添加REV即可,例如:
升序 获取sorted set 中的指定元素的排名:ZRANK key member降序 获取sorted set 中的指定元素的排名:ZREVRANK key memeber
Redis的Java客户端-Jedis 在Redis官网中提供了各种语言的客户端,地址:https://redis.io/docs/clients/
Jedis Startup
创建工程
引入依赖
1 2 3 4 5 6 7 8 9 10 11 12 13 <dependency > <groupId > redis.clients</groupId > <artifactId > jedis</artifactId > <version > 3.7.0</version > </dependency > <dependency > <groupId > org.junit.jupiter</groupId > <artifactId > junit-jupiter</artifactId > <version > 5.7.0</version > <scope > test</scope > </dependency >
建立连接
新建一个单元测试类,内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
private Jedis jedis;@BeforeEach void setUp () { jedis = JedisConnectionFactory.getJedis(); jedis.auth("123321" ); jedis.select(0 ); }
测试
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
@Test void testString () { String result = jedis.set("name" , "虎哥" ); System.out.println("result = " + result); String name = jedis.get("name" ); System.out.println("name = " + name); } @Test void testHash () { jedis.hset("user:1" , "name" , "Jack" ); jedis.hset("user:1" , "age" , "21" ); Map<String, String> map = jedis.hgetAll("user:1" ); System.out.println(map); }
释放资源
1
2
3
4
5
6
@AfterEach void tearDown () { if (jedis != null ) { jedis.close(); } }
Jedis连接池 Jedis本身是线程不安全的,并且频繁的创建和销毁连接会有性能损耗,因此我们推荐大家使用Jedis连接池代替Jedis的直连方式
有关池化思想,并不仅仅是这里会使用,很多地方都有,比如说我们的数据库连接池,比如我们tomcat中的线程池,这些都是池化思想的体现。
创建Jedis连接池
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class JedisConnectionFacotry { private static final JedisPool jedisPool; static { JedisPoolConfig poolConfig = new JedisPoolConfig (); poolConfig.setMaxTotal(8 ); poolConfig.setMaxIdle(8 ); poolConfig.setMinIdle(0 ); poolConfig.setMaxWaitMillis(1000 ); jedisPool = new JedisPool (poolConfig, "192.168.150.101" ,6379 ,1000 ,"123321" ); } public static Jedis getJedis () { return jedisPool.getResource(); } }
代码说明:
1) JedisConnectionFacotry:工厂设计模式是实际开发中非常常用的一种设计模式,我们可以使用工厂,去降低代的耦合,比如Spring中的Bean的创建,就用到了工厂设计模式
2)静态代码块:随着类的加载而加载,确保只能执行一次,我们在加载当前工厂类的时候,就可以执行static的操作完成对 连接池的初始化
3)最后提供返回连接池中连接的方法.
改造原始代码
代码说明:
1.在我们完成了使用工厂设计模式来完成代码的编写之后,我们在获得连接时,就可以通过工厂来获得。
,而不用直接去new对象,降低耦合,并且使用的还是连接池对象。
2.当我们使用了连接池后,当我们关闭连接其实并不是关闭,而是将Jedis还回连接池的。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
@BeforeEach void setUp () { jedis = JedisConnectionFacotry.getJedis(); jedis.select(0 ); } @AfterEach void tearDown () { if (jedis != null ) { jedis.close(); } }
Redis的Java客户端-SpringDataRedis SpringData是Spring中数据操作的模块,包含对各种数据库的集成,其中对Redis的集成模块就叫做SpringDataRedis,官网地址:https://spring.io/projects/spring-data-redis
提供了对不同Redis客户端的整合(Lettuce和Jedis)
提供了RedisTemplate统一API来操作Redis
支持Redis的发布订阅模型
支持Redis哨兵和Redis集群
支持基于Lettuce的响应式编程
支持基于JDK.JSON.字符串.Spring对象的数据序列化及反序列化
支持基于Redis的JDKCollection实现
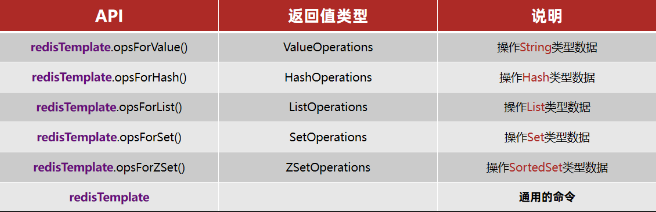
SpringDataRedis中提供了RedisTemplate工具类,其中封装了各种对Redis的操作。并且将不同数据类型的操作API封装到了不同的类型中:
基本使用
导入POM坐标
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
<?xml version="1.0" encoding="UTF-8" ?> <project xmlns ="http://maven.apache.org/POM/4.0.0" xmlns:xsi ="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation ="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd" > <modelVersion > 4.0.0</modelVersion > <parent > <groupId > org.springframework.boot</groupId > <artifactId > spring-boot-starter-parent</artifactId > <version > 2.5.7</version > <relativePath /> </parent > <groupId > com.heima</groupId > <artifactId > redis-demo</artifactId > <version > 0.0.1-SNAPSHOT</version > <name > redis-demo</name > <description > Demo project for Spring Boot</description > <properties > <java.version > 1.8</java.version > </properties > <dependencies > <dependency > <groupId > org.springframework.boot</groupId > <artifactId > spring-boot-starter-data-redis</artifactId > </dependency > <dependency > <groupId > org.apache.commons</groupId > <artifactId > commons-pool2</artifactId > </dependency > <dependency > <groupId > com.fasterxml.jackson.core</groupId > <artifactId > jackson-databind</artifactId > </dependency > <dependency > <groupId > org.projectlombok</groupId > <artifactId > lombok</artifactId > <optional > true</optional > </dependency > <dependency > <groupId > org.springframework.boot</groupId > <artifactId > spring-boot-starter-test</artifactId > <scope > test</scope > </dependency > </dependencies > <build > <plugins > <plugin > <groupId > org.springframework.boot</groupId > <artifactId > spring-boot-maven-plugin</artifactId > <configuration > <excludes > <exclude > <groupId > org.projectlombok</groupId > <artifactId > lombok</artifactId > </exclude > </excludes > </configuration > </plugin > </plugins > </build > </project >
配置文件
1
2
3
4
5
6
7
8
9
10
11
spring: redis: host: 120.48 .60 .222 port: 6379 password: 333 lettuce: pool: max-active: 8 max-idle: 8 min-idle: 0 max-wait: 100ms
测试代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
@SpringBootTest class RedisDemoApplicationTests { @Autowired private RedisTemplate<String, Object> redisTemplate; @Test void testString () { redisTemplate.opsForValue().set("name" , "虎哥" ); Object name = redisTemplate.opsForValue().get("name" ); System.out.println("name = " + name); } }
SpringDataRedis的使用步骤:
引入spring-boot-starter-data-redis依赖
在application.yml配置Redis信息
注入RedisTemplate
数据序列化器 可以自定义RedisTemplate的序列化方式,代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
@Configuration public class RedisConfig { @Bean public RedisTemplate<String, Object> redisTemplate (RedisConnectionFactory connectionFactory) { RedisTemplate<String, Object> template = new RedisTemplate <>(); template.setConnectionFactory(connectionFactory); GenericJackson2JsonRedisSerializer jsonRedisSerializer = new GenericJackson2JsonRedisSerializer (); template.setKeySerializer(RedisSerializer.string()); template.setHashKeySerializer(RedisSerializer.string()); template.setValueSerializer(jsonRedisSerializer); template.setHashValueSerializer(jsonRedisSerializer); return template; } }
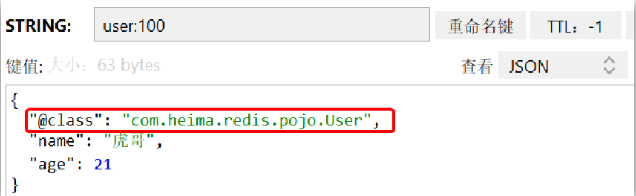
StringRedisTemplate 尽管JSON的序列化方式可以满足我们的需求,但依然存在一些问题,如图:
为了在反序列化时知道对象的类型,JSON序列化器会将类的class类型写入json结果中,存入Redis,会带来额外的内存开销。
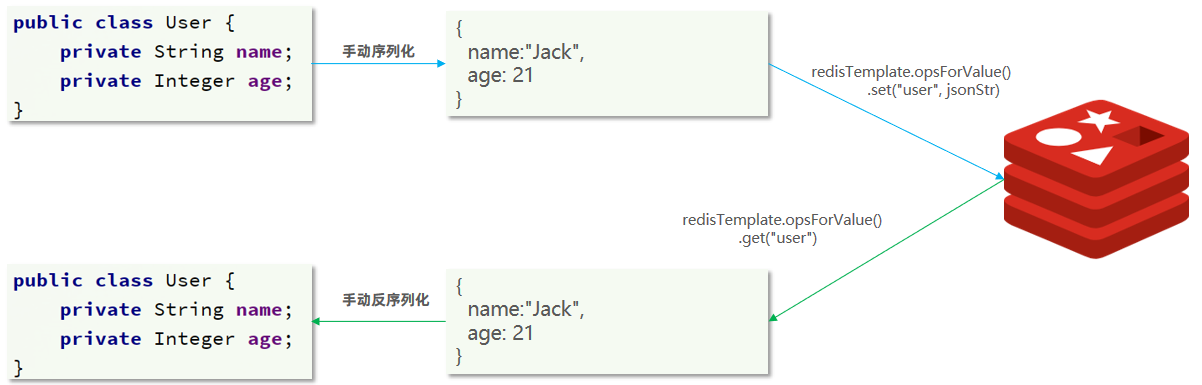
为了减少内存的消耗,我们可以采用手动序列化的方式,换句话说,就是不借助默认的序列化器,而是我们自己来控制序列化的动作,同时,我们只采用String的序列化器,这样,在存储value时,我们就不需要在内存中就不用多存储数据,从而节约我们的内存空间
这种用法比较普遍,因此SpringDataRedis就提供了RedisTemplate的子类:StringRedisTemplate,它的key和value的序列化方式默认就是String方式。
省去了我们自定义RedisTemplate的序列化方式的步骤,而是直接使用:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
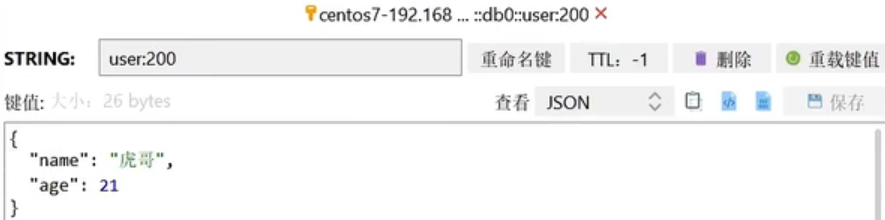
@SpringBootTest class RedisStringTests { @Autowired private StringRedisTemplate stringRedisTemplate; @Test void testString () { stringRedisTemplate.opsForValue().set("verify:phone:13600527634" , "124143" ); Object name = stringRedisTemplate.opsForValue().get("name" ); System.out.println("name = " + name); } private static final ObjectMapper mapper = new ObjectMapper (); @Test void testSaveUser () throws JsonProcessingException { User user = new User ("虎哥" , 21 ); String json = mapper.writeValueAsString(user); stringRedisTemplate.opsForValue().set("user:200" , json); String jsonUser = stringRedisTemplate.opsForValue().get("user:200" ); User user1 = mapper.readValue(jsonUser, User.class); System.out.println("user1 = " + user1); } }
此时我们再来看一看存储的数据,小伙伴们就会发现那个class数据已经不在了,节约了我们的空间
最后小总结:
RedisTemplate的两种序列化实践方案:
方案一:
自定义RedisTemplate
修改RedisTemplate的序列化器为GenericJackson2JsonRedisSerializer
方案二:
使用StringRedisTemplate
写入Redis时,手动把对象序列化为JSON
读取Redis时,手动把读取到的JSON反序列化为对象
Hash结构操作 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 @SpringBootTest class RedisStringTests { @Autowired private StringRedisTemplate stringRedisTemplate; @Test void testHash () { stringRedisTemplate.opsForHash().put("user:400" , "name" , "虎哥" ); stringRedisTemplate.opsForHash().put("user:400" , "age" , "21" ); Map<Object, Object> entries = stringRedisTemplate.opsForHash().entries("user:400" ); System.out.println("entries = " + entries); } }
Jedis 需要先导入两个包:
1 2 3 4 5 6 7 8 9 10 11 12 <dependency > <groupId > redis.clients</groupId > <artifactId > jedis</artifactId > <version > 3.7.0</version > </dependency > <dependency > <groupId > com.alibaba</groupId > <artifactId > fastjson</artifactId > <version > 1.2.78</version > </dependency >
实例化对象
1 2 Jedis jedis = new Jedis ("127.0.0.1" ,6379 );System.out.println("连接成功" );
常用API
基本操作
1 2 3 4 5 6 7 8 9 10 public class TestPassword { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); jedis.connect(); jedis.disconnect(); jedis.flushAll(); } }
key 操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 public class TestKey { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); System.out.println("清空数据:" +jedis.flushDB()); System.out.println("判断某个键是否存在:" +jedis.exists("username" )); System.out.println("新增<'username','kuangshen'>的键值 对:" +jedis.set("username" , "kuangshen" )); System.out.println("新增<'password','password'>的键值 对:" +jedis.set("password" , "password" )); System.out.print("系统中所有的键如下:" ); Set<String> keys = jedis.keys("*" ); System.out.println(keys); System.out.println("删除键password:" +jedis.del("password" )); System.out.println("判断键password是否存 在:" +jedis.exists("password" )); System.out.println("查看键username所存储的值的类 型:" +jedis.type("username" )); System.out.println("随机返回key空间的一个:" +jedis.randomKey()); System.out.println("重命名key:" +jedis.rename("username" ,"name" )); System.out.println("取出改后的name:" +jedis.get("name" )); System.out.println("按索引查询:" +jedis.select(0 )); System.out.println("删除当前选择数据库中的所有key:" +jedis.flushDB()); System.out.println("返回当前数据库中key的数目:" +jedis.dbSize()); System.out.println("删除所有数据库中的所有key:" +jedis.flushAll()); } }
String操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 public class TestString { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); jedis.flushDB(); System.out.println("===========增加数据===========" ); System.out.println(jedis.set("key1" ,"value1" )); System.out.println(jedis.set("key2" ,"value2" )); System.out.println(jedis.set("key3" , "value3" )); System.out.println("删除键key2:" +jedis.del("key2" )); System.out.println("获取键key2:" +jedis.get("key2" )); System.out.println("修改key1:" +jedis.set("key1" , "value1Changed" )); System.out.println("获取key1的值:" +jedis.get("key1" )); System.out.println("在key3后面加入值:" +jedis.append("key3" , "End" )); System.out.println("key3的值:" +jedis.get("key3" )); System.out.println("增加多个键值对:" +jedis.mset("key01" ,"value01" ,"key02" ,"value02" ,"key03" ,"value03" )); System.out.println("获取多个键值对:" +jedis.mget("key01" ,"key02" ,"key03" )); System.out.println("获取多个键值对:" +jedis.mget("key01" ,"key02" ,"key03" ,"key04" )); System.out.println("删除多个键值对:" +jedis.del("key01" ,"key02" )); System.out.println("获取多个键值对:" +jedis.mget("key01" ,"key02" ,"key03" )); jedis.flushDB(); System.out.println("===========新增键值对防止覆盖原先值==============" ); System.out.println(jedis.setnx("key1" , "value1" )); System.out.println(jedis.setnx("key2" , "value2" )); System.out.println(jedis.setnx("key2" , "value2-new" )); System.out.println(jedis.get("key1" )); System.out.println(jedis.get("key2" )); System.out.println("===========新增键值对并设置有效时间=============" ); System.out.println(jedis.setex("key3" , 2 , "value3" )); System.out.println(jedis.get("key3" )); try { TimeUnit.SECONDS.sleep(3 ); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println(jedis.get("key3" )); System.out.println("===========获取原值,更新为新值==========" ); System.out.println(jedis.getSet("key2" , "key2GetSet" )); System.out.println(jedis.get("key2" )); System.out.println("获得key2的值的字串:" +jedis.getrange("key2" , 2 , 4 )); } }
list 操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 public class TestList { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); jedis.flushDB(); System.out.println("===========添加一个list===========" ); jedis.lpush("collections" , "ArrayList" , "Vector" , "Stack" , "HashMap" , "WeakHashMap" , "LinkedHashMap" ); jedis.lpush("collections" , "HashSet" ); jedis.lpush("collections" , "TreeSet" ); jedis.lpush("collections" , "TreeMap" ); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("collections区间0-3的元素:" +jedis.lrange("collections" ,0 ,3 )); System.out.println("===============================" ); System.out.println("删除指定元素个数:" +jedis.lrem("collections" , 2 ,"HashMap" )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("删除下表0-3区间之外的元素:" +jedis.ltrim("collections" , 0 , 3 )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("collections列表出栈(左端):" +jedis.lpop("collections" )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("collections添加元素,从列表右端,与lpush相对应:" +jedis.rpush("collections" , "EnumMap" )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("collections列表出栈(右端):" +jedis.rpop("collections" )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("修改collections指定下标1的内 容:" +jedis.lset("collections" , 1 , "LinkedArrayList" )); System.out.println("collections的内容:" +jedis.lrange("collections" ,0 , -1 )); System.out.println("===============================" ); System.out.println("collections的长度:" +jedis.llen("collections" )); System.out.println("获取collections下标为2的元素:" +jedis.lindex("collections" , 2 )); System.out.println("===============================" ); jedis.lpush("sortedList" , "3" ,"6" ,"2" ,"0" ,"7" ,"4" ); System.out.println("sortedList排序前:" +jedis.lrange("sortedList" , 0 ,-1 )); System.out.println(jedis.sort("sortedList" )); System.out.println("sortedList排序后:" +jedis.lrange("sortedList" , 0 ,-1 )); } }
set操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 public class TestSet { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); jedis.flushDB(); System.out.println("============向集合中添加元素(不重复)============" ); System.out.println(jedis.sadd("eleSet" ,"e1" ,"e2" ,"e4" ,"e3" ,"e0" ,"e8" ,"e7" ,"e5" )); System.out.println(jedis.sadd("eleSet" , "e6" )); System.out.println(jedis.sadd("eleSet" , "e6" )); System.out.println("eleSet的所有元素为:" +jedis.smembers("eleSet" )); System.out.println("删除一个元素e0:" +jedis.srem("eleSet" , "e0" )); System.out.println("eleSet的所有元素为:" +jedis.smembers("eleSet" )); System.out.println("删除两个元素e7和e6:" +jedis.srem("eleSet" ,"e7" ,"e6" )); System.out.println("eleSet的所有元素为:" +jedis.smembers("eleSet" )); System.out.println("随机的移除集合中的一个元素:" +jedis.spop("eleSet" )); System.out.println("随机的移除集合中的一个元素:" +jedis.spop("eleSet" )); System.out.println("eleSet的所有元素为:" +jedis.smembers("eleSet" )); System.out.println("eleSet中包含元素的个数:" +jedis.scard("eleSet" )); System.out.println("e3是否在eleSet中:" +jedis.sismember("eleSet" ,"e3" )); System.out.println("e1是否在eleSet中:" +jedis.sismember("eleSet" ,"e1" )); System.out.println("e1是否在eleSet中:" +jedis.sismember("eleSet" ,"e5" )); System.out.println("=================================" ); System.out.println(jedis.sadd("eleSet1" ,"e1" ,"e2" ,"e4" ,"e3" ,"e0" ,"e8" ,"e7" ,"e5" )); System.out.println(jedis.sadd("eleSet2" ,"e1" ,"e2" ,"e4" ,"e3" ,"e0" ,"e8" )); System.out.println("将eleSet1中删除e1并存入eleSet3中:" +jedis.smove("eleSet1" , "eleSet3" , "e1" )); System.out.println("将eleSet1中删除e2并存入eleSet3中:" +jedis.smove("eleSet1" , "eleSet3" , "e2" )); System.out.println("eleSet1中的元素:" +jedis.smembers("eleSet1" )); System.out.println("eleSet3中的元素:" +jedis.smembers("eleSet3" )); System.out.println("============集合运算=================" ); System.out.println("eleSet1中的元素:" +jedis.smembers("eleSet1" )); System.out.println("eleSet2中的元素:" +jedis.smembers("eleSet2" )); System.out.println("eleSet1和eleSet2的交集:" +jedis.sinter("eleSet1" ,"eleSet2" )); System.out.println("eleSet1和eleSet2的并集:" +jedis.sunion("eleSet1" ,"eleSet2" )); System.out.println("eleSet1和eleSet2的差集:" +jedis.sdiff("eleSet1" ,"eleSet2" )); jedis.sinterstore("eleSet4" ,"eleSet1" ,"eleSet2" ); dstkey的集合 System.out.println("eleSet4中的元素:" +jedis.smembers("eleSet4" )); } }
hash操作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 public class TestHash { public static void main (String[] args) { Jedis jedis = new Jedis ("127.0.0.1" , 6379 ); jedis.flushDB(); Map<String,String> map = new HashMap <>(); map.put("key1" ,"value1" ); map.put("key2" ,"value2" ); map.put("key3" ,"value3" ); map.put("key4" ,"value4" ); jedis.hmset("hash" ,map); jedis.hset("hash" , "key5" , "value5" ); System.out.println("散列hash的所有键值对为:" +jedis.hgetAll("hash" )); System.out.println("散列hash的所有键为:" +jedis.hkeys("hash" )); System.out.println("散列hash的所有值为:" +jedis.hvals("hash" )); System.out.println("将key6保存的值加上一个整数,如果key6不存在则添加key6:" +jedis.hincrBy("hash" , "key6" , 6 )); System.out.println("散列hash的所有键值对为:" +jedis.hgetAll("hash" )); System.out.println("将key6保存的值加上一个整数,如果key6不存在则添加key6:" +jedis.hincrBy("hash" , "key6" , 3 )); System.out.println("散列hash的所有键值对为:" +jedis.hgetAll("hash" )); System.out.println("删除一个或者多个键值对:" +jedis.hdel("hash" ,"key2" )); System.out.println("散列hash的所有键值对为:" +jedis.hgetAll("hash" )); System.out.println("散列hash中键值对的个数:" +jedis.hlen("hash" )); System.out.println("判断hash中是否存在key2:" +jedis.hexists("hash" ,"key2" )); System.out.println("判断hash中是否存在key3:" +jedis.hexists("hash" ,"key3" )); System.out.println("获取hash中的值:" +jedis.hmget("hash" ,"key3" )); System.out.println("获取hash中的值:" +jedis.hmget("hash" ,"key3" ,"key4" )); } }