注:本学习笔记以及案例来源于黑马程序员C语言入门教程. 有修改。
C语言-概述
C语言
一提到语言这个词语,自然会想到的是像英语、汉语等这样的自然语言,因为它是人和人交换信息不可缺少的工具。
而今天计算机遍布了我们生活的每一个角落,除了人和人的相互交流之外,我们必须和计算机角落。
用什么的什么样的方式和计算机做最直接的交流呢?人们自然想到的是最古老也最方便的方式——语言,而C语言就是人和计算机交流的一种语言。
语言是用来交流沟通的。有一方说,有另一方听,必须有两方参与,这是语言最重要的功能:
说的一方传递信息,听的一方接收信息;
说的一方下达指令,听的一方遵循命令做事情。
语言是人和人交流,C语言是人和机器交流。只是,人可以不听另外一个人,但是,计算机是无条件服从。
语言有独特的语法规则和定义,双方必须遵循这些规则和定义才能实现真正的交流。
为什么学C语言
C语言特点
- 优点
- 代码量小
- 执行速度快
- 功能强大
- 编程自由
- 缺点
- 写代码实现周期长
- 可移植性较差
- 过于自由,经验不足易出错
- 对平台库依赖较多
C语言应用领域
C语言的应用极其广泛,从网站后台,到底层操作系统,从多媒体应用到大型网络游戏,均可使用C语言来开发:
写网站后台程序
专门针对某个主题写出功能强大的程序库
写出大型游戏的引擎
写出另一个语言来
写操作系统和驱动程序,并且只能用C语言编写
任何设备只要配置了微处理器,就都支持C语言。从微波炉到手机,都是由C语言技术来推动的
![[img/clip_image002.png]]
C语言关键字
C语言仅有32个关键字,9种控制语句,34种运算符,却能完成无数的功能:
![[img/clip_image002-1600476849331.jpg]]
![[img/clip_image002-1600476855287.jpg]]
![[img/clip_image002-1600476859772.jpg]]
第一个C语言程序:HelloWorld
编写C语言代码:hello.c
1 |
|
C语言的源代码文件是一个普通的文本文件,但扩展名必须是.c
![[img/image-20200919090134713.png]]
通过gcc编译C代码
- gcc编译器介绍
编辑器(如vi、记事本)是指我用它来写程序的(编辑代码),而我们写的代码语句,电脑是不懂的,我们需要把它转成电脑能懂的语句,编译器就是这样的转化工具。就是说,我们用编辑器编写程序,由编译器编译后才可以运行!
编译器是将易于编写、阅读和维护的高级计算机语言翻译为计算机能解读、运行的低级机器语言的程序
gcc(GNU Compiler Collection,GNU 编译器套件),是由 GNU 开发的编程语言编译器。gcc原本作为GNU操作系统的官方编译器,现已被大多数类Unix操作系统(如Linux、BSD、Mac OS X等)采纳为标准的编译器,gcc同样适用于微软的Windows
gcc最初用于编译C语言,随着项目的发展gcc已经成为了能够编译C、C++、Java、Ada、fortran、Object C、Object C++、Go语言的编译器大家族
编译命令格式:
1 | gcc [-option1] ... <filename> |
命令、选项和源文件之间使用空格分隔
一行命令中可以有零个、一个或多个选项
文件名可以包含文件的绝对路径,也可以使用相对路径
如果命令中不包含输出可执行文件的文件名,可执行文件的文件名会自动生成一个默认名,Linux平台为
a.out,Windows平台为a.exe
gcc、g++编译常用选项说明:
| 选项 | 含义 |
|---|---|
| -o file | 指定生成的输出文件名为file |
| -E | 只进行预处理 |
| -S(大写) | 只进行预处理和编译 |
| -c(小写) | 只进行预处理、编译和汇编 |
- Windows平台下gcc环境配置
windows命令行界面下,默认是没有gcc编译器,我们需要配置一下环境
MinGW, 安装使用教程参看:MinGW安装教程
- linux平台下gcc环境配置
参考教程:详解Linux安装GCC方法
代码分析
1 | #include <stdio.h> |
- include头文件包含
#include< >与#include ""的区别:< >表示系统直接按系统指定的目录检索" "表示系统先在" "指定的路径(没写路径代表当前路径)查找头文件,如果找不到,再按系统指定的目录检索
stdio.h 在操作系统/usr/include/目录下
![[img/image-20200919092034856.png]]
- main函数
- 一个完整的C语言程序,是由一个、且只能有一个
main()函数(又称主函数,必须有)和若干个其他函数结合而成(可选) main函数是C语言程序的入口,程序是从main函数开始执行
- {} 括号,程序体和代码块
{}叫代码块,一个代码块内部可以有一条或者多条语句- C语言每句可执行代码都是”
;“分号结尾 - 所有的
#开头的行,都代表预编译指令,预编译指令行结尾是没有分号的 - 所有的可执行语句必须是在代码块里面
- 注释
//叫行注释,注释的内容编译器是忽略的,注释主要的作用是在代码中加一些说明和解释,这样有利于代码的阅读/**/叫块注释- 块注释是C语言标准的注释方法
- 行注释是从C++语言借鉴过来的
- printf函数
printf是C语言库函数,功能是向标准输出设备输出一个字符串printf(“hello world\n”);//\n的意思是回车换行
- return语句
return代表函数执行完毕,返回return代表函数的终止如果main定义的时候前面是
int,那么return后面就需要写一个整数;如果main定义的时候前面是void,那么return后面什么也不需要写在main函数中
return 0代表程序执行成功,return -1代表程序执行失败int main()和void main()在C语言中是一样的,但C++只接受int main这种定义方式
system函数
system函数的使用
1 | #include <stdlib.h> |
功能:在已经运行的程序中执行另外一个外部程序
参数:外部可执行程序名字
返回值:
成功:0
失败:任意数字
1 |
|
![[img/image-20200919094712699.png]]
C语言编译过程
C程序编译步骤
C代码编译成可执行程序经过4步:
- 预处理:宏定义展开、头文件展开、条件编译等,同时将代码中的注释删除,这里并不会检查语法
- 编译:检查语法,将预处理后文件编译生成汇编文件
- 汇编:将汇编文件生成目标文件(二进制文件)
- 链接:C语言写的程序是需要依赖各种库的,所以编译之后还需要把库链接到最终的可执行程序中去
![[img/clip_image002-1600480373517.png]]
VS 执行结果一闪而过的解决方法:
system("pause");项目->属性->配置属性->链接器->系统->子系统->控制台 增加“/SUBSYSTEM:CONSOLE”链接选项即可
gcc 编译过程
- 分步编译
预处理:
gcc -E introduce.c -o introduce.i
编 译:
gcc -S introduce.i -o introduce.s
汇 编:
gcc -c introduce.s -o introduce.o
链 接:
gcc introduce.o -o introduce
| 选项 | 含义 |
|---|---|
| -E | 只进行预处理 |
| -S(大写) | 只进行预处理和编译 |
| -c(小写) | 只进行预处理、编译和汇编 |
| -o file | 指定生成的输出文件名为 file |
| 文件后缀 | 含义 |
|---|---|
| .c | C 语言文件 |
| .i | 预处理后的 C 语言文件 |
| .s | 编译后的汇编文件 |
| .o | 编译后的目标文件 |
编译的时候最后两倒数第二步的时候用了大写C
gcc -C introduce.s -o introduce.o
gcc introduce.o -o introduce
导致了如下问题, 记录一下
1 | /usr/bin/ld: /usr/lib/gcc/x86_64-linux-gnu/8/../../../x86_64-linux-gnu/Scrt1.o: in function `_start': |
![[img/image-20200919101105887.png]]
正确的编译过程
1 | gcc -E introduce.c -o introduce.i |
![[img/image-20200919101944251.png]]
- 一步编译
gcc introduce.c -o introduce1 // 自动完成:预处理、编译、汇编、链接的过程
![[img/image-20200919102259922.png]]
查找程序所依赖的动态库
Windows平台下,需要相应软件(Depends.exe):
![[img/image-20200919102850515.png]]
![[img/image-20200919102938934.png]]
CPU内部结构与寄存器
64位和32位系统区别
寄存器是CPU内部最基本的存储单元
CPU对外是通过总线(地址、控制、数据)来和外部设备交互的,总线的宽度是8位,同时CPU的寄存器也是8位,那么这个CPU就叫8位CPU
如果总线是32位,寄存器也是32位的,那么这个CPU就是32位CPU
有一种CPU内部的寄存器是32位的,但总线是16位,准32为CPU
所有的64位CPU兼容32位的指令,32位要兼容16位的指令,所以在64位的CPU上是可以识别32位的指令
在64位的CPU构架上运行了64位的软件操作系统,那么这个系统是64位
在64位的CPU构架上,运行了32位的软件操作系统,那么这个系统就是32位
64位的软件不能运行在32位的CPU之上
寄存器名字
| 8位 | 16位 | 32位 | 64位 |
|---|---|---|---|
| A | AX | EAX | RAX |
| B | BX | EBX | RBX |
| C | CX | ECX | RCX |
| D | DX | EDX | RDX |
寄存器、缓存、内存三者关系
按与CPU远近来分,离得最近的是寄存器,然后缓存(CPU缓存),最后内存。
CPU计算时,先预先把要用的数据从硬盘读到内存,然后再把即将要用的数据读到寄存器。于是 CPU<—>寄存器<—>内存,这就是它们之间的信息交换。
那为什么有缓存呢?因为如果经常操作内存中的同一址地的数据,就会影响速度。于是就在寄存器与内存之间设置一个缓存。
因为从存提取的速度远高于内存。当然缓存的价格肯定远远高于内存,不然的话,机器里就没有内存的存在。
汇编语言
VS中C语言嵌套汇编代码
1 |
|
VS反编译
1 |
|
C语言-数据类型
常量与变量
关键字
![[img/clip_image002-1600484267948.jpg]]
数据类型
数据类型的作用:编译器预算对象(变量)分配的内存空间大小
![[img/clip_image002-1600484293600.jpg]]
常量
常量:
- 在程序运行过程中,其值不能被改变的量
- 常量一般出现在表达式或赋值语句中
| 整型常量 | 100,200,-100,0 |
|---|---|
| 实型常量 | 3.14 , 0.125,-3.123 |
| 字符型常量 | ‘a’,‘b’,‘1’,‘\n’ |
| 字符串常量 | “a”,“ab”,“12356” |
变量
1. 变量
- 在程序运行过程中,其值可以改变
- 变量在使用前必须先定义,定义变量前必须有相应的数据类型
标识符命名规则:
- 标识符不能是关键字
- 标识符只能由字母、数字、下划线组成
- 第一个字符必须为字母或下划线
- 标识符中字母区分大小写
变量特点:
- 变量在编译时为其分配相应的内存空间
- 可以通过其名字和地址>访问相应内存
![[img/clip_image002-1600484648234.jpg]]
2. 声明和定义区别
- 声明变量不需要建立存储空间,如:
extern int a; - 定义变量需要建立存储空间,如:
int b;
1 |
|
从广义的角度来讲声明中包含着定义,即定义是声明的一个特例,所以并非所有的声明都是定义:
int b它既是声明,同时又是定义对于
extern b来讲它只是声明不是定义
一般的情况下,把建立存储空间的声明称之为“定义”,而把不需要建立存储空间的声明称之为“声明”
使用示例
1 |
|
整数:int
整型变量的定义和输出
| 打印格式 | 含义 |
|---|---|
| %d | 输出一个有符号的10进制int类型 |
| %o(字母o) | 输出8进制的int类型 |
| %x | 输出16进制的int类型,字母以小写输出 |
| %X | 输出16进制的int类型,字母以大写输出 |
| %u | 输出一个10进制的无符号数 |
1 |
|
![[img/image-20200919133924510.png]]
整型变量的输入
1 |
|
short、int、long、long long
| 数据类型 | 占用空间 |
|---|---|
| short(短整型) | 2字节 |
| int(整型) | 4字节 |
| long(长整形) | Windows为4字节,Linux为4字节(32位),8字节(64位) |
| long long(长长整形) | 8字节 |
注意:
- 整型数据在内存中占的字节数与所选择的操作系统有关。虽然 C 语言标准中没有明确规定整型数据的长度,但 long 类型整数的长度不能短于 int 类型, short 类型整数的长度不能长于 int 类型
- 当一个小的数据类型赋值给一个大的数据类型,不会出错,因为编译器会自动转化。但当一个大的类型赋值给一个小的数据类型,那么就可能丢失高位
| 整型常量 | 所需类型 |
|---|---|
| 10 | 代表int类型 |
| 10l, 10L | 代表long类型 |
| 10ll, 10LL | 代表long long类型 |
| 10u, 10U | 代表unsigned int类型 |
| 10ul, 10UL | 代表unsigned long类型 |
| 10ull, 10ULL | 代表unsigned long long类型 |
| 打印格式 | 含义 |
|---|---|
| %hd | 输出short类型 |
| %d | 输出int类型 |
| %ld | 输出long类型 |
| %lld | 输出long long类型 |
| %hu | 输出unsigned short类型 |
| %u | 输出unsigned int类型 |
| %lu | 输出unsigned long类</型 |
| %llu | 输出unsigned long long类型 |
1 |
|
输出:
1 | tao@Taoc:~/Desktop/C/2$ ./2.2.3 |
有符号数和无符号数区别
1. 有符号数
有符号数是最高位为符号位,0代表正数,1代表负数
1 |
|
输出: BF0FF0BA
2. 无符号数
无符号数最高位不是符号位, 而就是数的一部分,无符号数不可能是负数
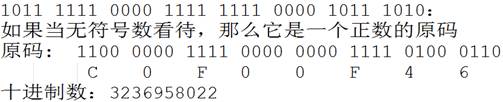
1 |
|
当我们写程序要处理一个不可能出现负值的时候,一般用无符号数,这样可以增大数的表达最大值
3. 有符号和无符号整型取值范围
| 数据类型 | 占用空间 | 取值范围 |
|---|---|---|
| short | 2字节 | -32768 到 32767 ($-2^{15}$ ~ 2$^{15}$-1) |
| int | 4字节 | -2147483648 到 2147483647 ($-2^{31}$ ~ $2^{31}$-1) |
| long | 4字节 | -2147483648 到 2147483647($-2^{31}$ ~ $2^{31}$-1) |
| unsigned short | 2字节 | 0 到 65535 (0 ~ 2$^{16}$-1) |
| unsigned int | 4字节 | 0 到 4294967295 (0 ~ 2$^{32}$-1) |
| unsigned long | 4字节 | 0 到 4294967295 (0 ~ 2$^{32}$-1) |
sizeof 关键字
sizeof不是函数,所以不需要包含任何头文件,它的功能是计算一个数据类型的大小,单位为字节sizeof的返回值为size_tsize_t类型在32位操作系统下是unsigned int,是一个无符号的整数
1 |
|
输出:
1 | tao@Taoc:~/Desktop/C/2$ ./2.3 |
字符型:char
字符变量的定义和输出
字符型变量用于存储一个单一字符,在 C 语言中用 char 表示,其中每个字符变量都会占用 1 个字节。在给字符型变量赋值时,需要用一对英文半角格式的单引号(' ')把字符括起来
字符变量实际上并不是把该字符本身放到变量的内存单元中去,而是将该字符对应的 ASCII 编码放到变量的存储单元中。char的本质就是一个1字节大小的整型
1 |
|
输出结果:
1 | ao@Taoc:~/Desktop/C/2$ ./2.4.1 |
字符变量的输入
1 |
|
输出:
1 | tao@Taoc:~/Desktop/C/2$ ./2.4.2 |
2.4.3 ASCII 对照表
| ASCII值 | 控制字符 | ASCII值 | 字符 | ASCII值 | 字符 | ASCII值 | 字符 |
|---|---|---|---|---|---|---|---|
| 0 | NUT | 32 | (space) | 64 | @ | 96 | 、 |
| 1 | SOH | 33 | ! | 65 | A | 97 | a |
| 2 | STX | 34 | “ | 66 | B | 98 | b |
| 3 | ETX | 35 | # | 67 | C | 99 | c |
| 4 | EOT | 36 | $ | 68 | D | 100 | d |
| 5 | ENQ | 37 | % | 69 | E | 101 | e |
| 6 | ACK | 38 | & | 70 | F | 102 | f |
| 7 | BEL | 39 | , | 71 | G | 103 | g |
| 8 | BS | 40 | ( | 72 | H | 104 | h |
| 9 | HT | 41 | ) | 73 | I | 105 | i |
| 10 | LF | 42 | * | 74 | J | 106 | j |
| 11 | VT | 43 | + | 75 | K | 107 | k |
| 12 | FF | 44 | , | 76 | L | 108 | l |
| 13 | CR | 45 | - | 77 | M | 109 | m |
| 14 | SO | 46 | . | 78 | N | 110 | n |
| 15 | SI | 47 | / | 79 | O | 111 | o |
| 16 | DLE | 48 | 0 | 80 | P | 112 | p |
| 17 | DCI | 49 | 1 | 81 | Q | 113 | q |
| 18 | DC2 | 50 | 2 | 82 | R | 114 | r |
| 19 | DC3 | 51 | 3 | 83 | S | 115 | s |
| 20 | DC4 | 52 | 4 | 84 | T | 116 | t |
| 21 | NAK | 53 | 5 | 85 | U | 117 | u |
| 22 | SYN | 54 | 6 | 86 | V | 118 | v |
| 23 | TB | 55 | 7 | 87 | W | 119 | w |
| 24 | CAN | 56 | 8 | 88 | X | 120 | x |
| 25 | EM | 57 | 9 | 89 | Y | 121 | y |
| 26 | SUB | 58 | : | 90 | Z | 122 | z |
| 27 | ESC | 59 | ; | 91 | [ | 123 | { |
| 28 | FS | 60 | < | 92 | / | 124 | | |
| 29 | GS | 61 | = | 93 | ] | 125 | } |
| 30 | RS | 62 | > | 94 | ^ | 126 | ` |
| 31 | US | 63 | ? | 95 | _ | 127 | DEL |
ASCII 码大致由以下两部分组成:
- ASCII 非打印控制字符: ASCII 表上的数字 0-31 分配给了控制字符,用于控制像打印机等一些外围设备
- ASCII 打印字符:数字 32-126 分配给了能在键盘上找到的字符,当查看或打印文档时就会出现。数字 127 代表 Del 命令
转义字符
| 转义字符 | 含义 | ASCII****码值(十进制) |
|---|---|---|
| \a | 警报 | 007 |
| \b | 退格(BS) ,将当前位置移到前一列 | 008 |
| \f | 换页(FF),将当前位置移到下页开头 | 012 |
| \n | 换行(LF) ,将当前位置移到下一行开头 | 010 |
| \r | 回车(CR) ,将当前位置移到本行开头 | 013 |
| \t | 水平制表(HT) (跳到下一个TAB位置) | 009 |
| \v | 垂直制表(VT) | 011 |
\\ |
代表一个反斜线字符”" | 092 |
\' |
代表一个单引号(撇号)字符 | 039 |
\" |
代表一个双引号字符 | 034 |
\? |
代表一个问号 | 063 |
\0 |
数字0 | 000 |
\ddd |
8进制转义字符,d范围0~7 | 3位8进制 |
\xhh |
16进制转义字符,h范围0 |
3位16进制 |
注意:红色字体标注的为不可打印字符
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/2$ ./2.4.4 |
实型(浮点型):float、double
实型变量也可以称为浮点型变量,浮点型变量是用来存储小数数值的。在C语言中, 浮点型变量分为两种: 单精度浮点数(float)、 双精度浮点数(double), 但是double型变量所表示的浮点数比 float 型变量更精确。
由于浮点型变量是由有限的存储单元组成的,因此只能提供有限的有效数字。在有效位以外的数字将被舍去,这样可能会产生一些误差。
不以f结尾的常量是double类型,以f结尾的常量(如3.14f)是float类型
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/2$ ./2.5 |
进制
进制也就是进位制,是人们规定的一种进位方法。 对于任何一种进制—X进制,就表示某一位置上的数运算时是逢X进一位。 十进制是逢十进一,十六进制是逢十六进一,二进制就是逢二进一,以此类推,x进制就是逢x进位
| 十进制 | 二进制 | 八进制 | 十六进制 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 1 | 1 | 1 | 1 |
| 2 | 10 | 2 | 2 |
| 3 | 11 | 3 | 3 |
| 4 | 100 | 4 | 4 |
| 5 | 101 | 5 | 5 |
| 6 | 110 | 6 | 6 |
| 7 | 111 | 7 | 7 |
| 8 | 1000 | 10 | 8 |
| 9 | 1001 | 11 | 9 |
| 10 | 1010 | 12 | A |
| 11 | 1011 | 13 | B |
| 12 | 1100 | 14 | C |
| 13 | 1101 | 15 | D |
| 14 | 1110 | 16 | E |
| 15 | 1111 | 17 | F |
| 16 | 10000 | 20 | 10 |
二进制
二进制是计算技术中广泛采用的一种数制。二进制数据是用0和1两个数码来表示的数。它的基数为2,进位规则是“逢二进一”,借位规则是“借一当二”
当前的计算机系统使用的基本上是二进制系统,数据在计算机中主要是以补码的形式存储的
| 术语 | 含义 |
|---|---|
| bit(比特) | 一个二进制代表一位,一个位只能表示0或1两种状态。数据传输是习惯以“位”(bit)为单位。 |
| Byte(字节) | 一个字节为8个二进制,称为8位,计算机中存储的最小单位是字节。数据存储是习惯以“字节”(Byte)为单位。 |
| WORD(双字节) | 2个字节,16位 |
| DWORD | 两个WORD,4个字节,32位 |
| 1b | 1bit,1位 |
| 1B | 1Byte,1字节,8位 |
| 1k,1K | 1024 |
| 1M(1兆) | 1024k, 1024*1024 |
| 1G | 1024M |
| 1T | 1024G |
| 1Kb(千位) | 1024bit,1024位 |
| 1KB(千字节) | 1024Byte,1024字节 |
| 1Mb(兆位) | 1024Kb = 1024 * 1024bit |
| 1MB(兆字节) | 1024KB = 1024 * 1024Byte |
十进制转化二进制的方法:用十进制数除以2,分别取余数和商数,商数为0的时候,将余数倒着数就是转化后的结果
![[img/clip_image002-1600500777852.png]]
十进制的小数转换成二进制:小数部分和2相乘,取整数,不足1取0,每次相乘都是小数部分,顺序看取整后的数就是转化后的结果
![[img/clip_image002-1600500801245.jpg]]
八进制
八进制,Octal,缩写OCT或O,一种以8为基数的计数法,采用0,1,2,3,4,5,6,7八个数字,逢八进1。一些编程语言中常常以数字0开始表明该数字是八进制
八进制的数和二进制数可以按位对应(八进制一位对应二进制三位),因此常应用在计算机语言中
![[img/clip_image002-1600500855480.jpg]]
十进制转化八进制的方法:
用十进制数除以8,分别取余数和商数,商数为0的时候,将余数倒着数就是转化后的结果
![[img/clip_image002-1600500866476.jpg]]
十六进制
十六进制(英文名称:Hexadecimal),同我们日常生活中的表示法不一样,它由0-9,A-F组成,字母不区分大小写。与10进制的对应关系是:0-9对应0-9,A-F对应10-15
十六进制的数和二进制数可以按位对应(十六进制一位对应二进制四位),因此常应用在计算机语言中
![[img/clip_image002-1600501357582.jpg]]
十进制转化十六进制的方法:
用十进制数除以16,分别取余数和商数,商数为0的时候,将余数倒着数就是转化后的结果
![[img/clip_image002-1600501365915.jpg]]
C语言如何表示相应进制数
| 十进制 | 以正常数字1-9开头,如123 |
|---|---|
| 八进制 | 以数字0开头,如0123 |
| 十六进制 | 以0x开头,如0x123 |
| 二进制 | C语言不能直接书写二进制数 |
1 |
|
输出:
1 | tao@Taoc:~/Desktop/C/2$ ./2.6.4 |
计算机内存数值存储方式
原码
一个数的原码(原始的二进制码)有如下特点:
- 最高位做为符号位,0表示正,为1表示负
- 其它数值部分就是数值本身绝对值的二进制数
- 负数的原码是在其绝对值的基础上,最高位变为1
下面数值以1字节的大小描述:
| 十进制数 | 原码 |
|---|---|
| +15 | 0000 1111 |
| -15 | 1000 1111 |
| +0 | 0000 0000 |
| -0 | 1000 0000 |
原码表示法简单易懂,与带符号数本身转换方便,只要符号还原即可,但当两个正数相减或不同符号数相加时,必须比较两个数哪个绝对值大,才能决定谁减谁,才能确定结果是正还是负,所以原码不便于加减运算
反码
- 对于正数,反码与原码相同
- 对于负数,符号位不变,其它部分取反(1变0,0变1)
| 十进制数 | 反码 |
|---|---|
| +15 | 0000 1111 |
| -15 | 1111 0000 |
| +0 | 0000 0000 |
| -0 | 1111 1111 |
反码运算也不方便,通常用来作为求补码的中间过渡
补码
在计算机系统中,数值一律用补码来存储
补码特点:
- 对于正数,原码、反码、补码相同
- 对于负数,其补码为它的反码加1
- 补码符号位不动,其他位求反,最后整个数加1,得到原码
| 十进制数 | 补码 |
|---|---|
| +15 | 0000 1111 |
| -15 | 1111 0001 |
| +0 | 0000 0000 |
| -0 | 0000 0000 |
1 |
|
补码的意义
示例1:用8位二进制数分别表示+0和-0
| 十进制数 | 原码 |
|---|---|
| +0 | 0000 0000 |
| -0 | 1000 0000 |
| 十进制数 | 反码 |
|---|---|
| +0 | 0000 0000 |
| -0 | 1111 1111 |
不管以原码方式存储,还是以反码方式存储,0也有两种表示形式。为什么同样一个0有两种不同的表示方法呢?
但是如果以补码方式存储,补码统一了零的编码:
| 十进制数 | 补码 |
|---|---|
| +0 | 0000 0000 |
| -0 | 10000 0000由于只用8位描述,最高位1丢弃,变为0000 0000 |
示例2:计算9-6的结果
以原码方式相加:
| 十进制数 | 原码 |
|---|---|
| 9 | 0000 1001 |
| -6 | 1000 0110 |
![[img/clip_image002-1600502184471.jpg]]
结果为-15,不正确。
以补码方式相加:
| 十进制数 | 补码 |
|---|---|
| 9 | 0000 1001 |
| -6 | 1111 1010 |
![[img/clip_image002-1600502207939.jpg]]
最高位的1溢出,剩余8位二进制表示的是3,正确
在计算机系统中,数值一律用补码来存储主要原因是:
- 统一了零的编码
- 将符号位和其它位统一处理
- 将减法运算转变为加法运算
- 两个用补码表示的数相加时,如果最高位(符号位)有进位,则进位被舍弃
数值溢出
当超过一个数据类型能够存放最大的范围时,数值会溢出
有符号位最高位溢出的区别:符号位溢出会导致数的正负发生改变,但最高位的溢出会导致最高位丢失
| 数据类型 | 占用空间 | 取值范围 |
|---|---|---|
| char | 1字节 | -128到 127(-2$^{7}$ ~ 2$^{7}$-1) |
| unsigned char | 1字节 | 0 到 255(0 ~ 2$^{8}$-1) |
1 |
|
1 | tao@Taoc:~/Desktop/C/2$ gcc 2.7.5.c -o 2.7.5 |
类型限定符
| 限定符 | 含义 |
|---|---|
| extern | 声明一个变量,extern声明的变量没有建立存储空间。 extern int a;//变量在定义的时候创建存储空间 |
| const | 定义一个常量,常量的值不能修改。 const int a = 10; |
| Volatile | 防止编译器优化代码 |
| register | 定义寄存器变量,提高效率。register是建议型的指令,而不是命令型的指令,如果CPU有空闲寄存器,那么register就生效,如果没有空闲寄存器,那么register无效。 |
字符串格式化输出和输入
字符串常量
- 字符串是内存中一段连续的char空间,以’
\0‘(数字0)结尾 - 字符串常量是由双引号括起来的字符序列,如“china”、“C program”,“$12.5”等都是合法的字符串常量
字符串常量与字符常量的不同:
![[img/clip_image002-1600503616364.jpg]]
每个字符串的结尾,编译器会自动的添加一个结束标志位’\0‘,即 “a” 包含两个字符’a‘和’\0’
printf函数和putchar函数
printf是输出一个字符串,putchar输出一个char
printf格式字符:
| 打印格式 | 对应数据类型 | 含义 |
|---|---|---|
| %d | int | 接受整数值并将它表示为有符号的十进制整数 |
| %hd | short int | 短整数 |
| %hu | unsigned short | 无符号短整数 |
| %o | unsigned int | 无符号8进制整数 |
| %u | unsigned int | 无符号10进制整数 |
| %x,%X | unsigned int | 无符号16进制整数,x对应的是abcdef,X对应的是ABCDEF |
| %f | float | 单精度浮点数 |
| %lf | double | 双精度浮点数 |
| %e,%E | double | 科学计数法表示的数,此处”e”的大小写代表在输出时用的”e”的大小写 |
| %c | char | 字符型。可以把输入的数字按照ASCII码相应转换为对应的字符 |
| %s | char * | 字符串。输出字符串中的字符直至字符串中的空字符(字符串以’\0‘结尾,这个’\0’即空字符) |
| %p | void * | 以16进制形式输出指针 |
| %% | % | 输出一个百分号 |
printf附加格式:
| 字符 | 含义 |
|---|---|
| l(字母l) | 附加在d,u,x,o前面,表示长整数 |
| - | 左对齐 |
| m(代表一个整数) | 数据最小宽度 |
| 0(数字0) | 将输出的前面补上0直到占满指定列宽为止不可以搭配使用- |
| m.n(代表一个整数) | m指域宽,即对应的输出项在输出设备上所占的字符数。n指精度,用于说明输出的实型数的小数位数。对数值型的来说,未指定n时,隐含的精度为n=6位。 |
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/2$ ./2.9.2 |
scanf函数与getchar函数
- getchar是从标准输入设备读取一个char
- scanf通过%转义的方式可以得到用户通过标准输入设备输入的数据
1 |
|
1 | tao@Taoc:~/Desktop/C/2$ gcc 2.9.3.c -o 2.9.3 |
C语言-运算符和表达式
常用运算符分类
| 运算符类型 | 作用 |
|---|---|
| 算术运算符 | 用于处理四则运算 |
| 赋值运算符 | 用于将表达式的值赋给变量 |
| 比较运算符 | 用于表达式的比较,并返回一个真值或假值 |
| 逻辑运算符 | 用于根据表达式的值返回真值或假值 |
| 位运算符 | 用于处理数据的位运算 |
| sizeof运算符 | 用于求字节数长度 |
算术运算符
| 运算符 | 术语 | 示例 | 结果 |
|---|---|---|---|
| + | 正号 | +3 | 3 |
| - | 负号 | -3 | -3 |
| + | 加 | 10 + 5 | 15 |
| - | 减 | 10 - 5 | 5 |
| * | 乘 | 10 * 5 | 50 |
| / | 除 | 10 / 5 | 2 |
| % | 取模(取余) | 10 % 3 | 1 |
| ++ | 前自增 | a=2; b=++a; | a=3; b=3; |
| ++ | 后自增 | a=2; b=a++; | a=3; b=2; |
| – | 前自减 | a=2; b=–a; | a=1; b=1; |
| – | 后自减 | a=2; b=a–; | a=1; b=2; |
赋值运算符
| 运算符 | 术语 | 示例 | 结果 |
|---|---|---|---|
| = | 赋值 | a=2; b=3; | a=2; b=3; |
| += | 加等于 | a=0; a+=2; | a=2; |
| -= | 减等于 | a=5; a-=3; | a=2; |
| *= | 乘等于 | a=2; a*=2; | a=4; |
| /= | 除等于 | a=4; a/=2; | a=2; |
| %= | 模等于 | a=3; a%2; | a=1; |
比较运算符
C 语言的比较运算中, “
真”用数字“1”来表示, “假”用数字“0”来表示
| 运算符 | 术语 | 示例 | 结果 |
|---|---|---|---|
| == | 相等于 | 4 == 3 | 0 |
| != | 不等于 | 4 != 3 | 1 |
| < | 小于 | 4 < 3 | 0 |
| > | 大于 | 4 > 3 | 1 |
| <= | 小于等于 | 4 <= 3 | 0 |
| >= | 大于等于 | 4 >= 1 | 1 |
逻辑运算符
| 运算符 | 术语 | 示例 | 结果 |
|---|---|---|---|
| ! | 非 | !a | 如果a为假,则!a为真; 如果a为真,则!a为假。 |
| && | 与 | a && b | 如果a和b都为真,则结果为真,否则为假。 |
| || | 或 | a || b | 如果a和b有一个为真,则结果为真,二者都为假时,结果为假。 |
【重点】运算符优先级
![[img/image-20200920092724191.png]]
类型转换
数据有不同的类型,不同类型数据之间进行混合运算时必然涉及到类型的转换问题
转换的方法有两种:
- 自动转换(隐式转换):遵循一定的规则,由编译系统自动完成。
- 强制类型转换:把表达式的运算结果强制转换成所需的数据类型。
类型转换的原则:占用内存字节数少(值域小)的类型,向占用内存字节数多(值域大)的类型转换,以保证精度不降低
![[img/clip_image002-1600565386733.jpg]]
隐式转换
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/3$ ./3.7.1 |
强制转换
强制类型转换指的是使用强制类型转换运算符,将一个变量或表达式转化成所需的类型,其基本语法格式如下所示:
(类型说明符) (表达式)
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/3$ ./3.7.2 |
C语言-程序流程结构
概述
C语言支持最基本的三种程序运行结构:顺序结构、选择结构、循环结构。
顺序结构:程序按顺序执行,不发生跳转。
选择结构:依据是否满足条件,有选择的执行相应功能。
循环结构:依据条件是否满足,循环多次执行某段代码。
选择结构
if语句
![[img/clip_image002-1600565899951.png]]
1 |
|
if…else语句
![[img/clip_image002-1600565955370.png]]
1 |
|
if…else if…else语句
![[img/clip_image002-1600565985028.png]]
1 |
|
三目运算符
![[img/2-1Q11512525J14.gif]]
1 |
|
switch语句
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/4$ ./4.2.5 |
循环语句
while语句
![[img/clip_image002-1600566360348.png]]
1 |
|
do…while语句
![[img/clip_image002-1600566398556.png]]
1 |
|
for 语句
1 |
|
嵌套循环
1 |
|
跳转语句break、continue、goto
break 语句
在switch条件语句和循环语句中都可以使用break语句:
- 当它出现在
switch条件语句中时,作用是终止某个case并跳出switch结构。 - 当它出现在循环语句中,作用是跳出当前内循环语句,执行后面的代码。
- 当它出现在嵌套循环语句中,跳出最近的内循环语句,执行后面的代码
1 | #include <stdio.h> |
输出结果:
1 | tao@Taoc:~/Desktop/C/4$ ./4.3.1 |
continue语句
在循环语句中,如果希望立即终止本次循环,并执行下一次循环,此时就需要使用continue语句
1 |
|
1 | tao@Taoc:~/Desktop/C/4$ ./4.4.2 |
goto语句(无条件跳转,尽量少用)
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/4$ ./4.4.3 |
C语言-数组和字符串
概述
在程序设计中,为了方便处理数据把具有相同类型的若干变量按有序形式组织起来——称为数组
数组就是在内存中连续的相同类型的变量空间。同一个数组所有的成员都是相同的数据类型,同时所有的成员在内存中的地址是连续的
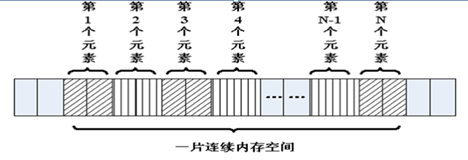
数组属于构造数据类型:
一个数组可以分解为多个数组元素:这些数组元素可以是基本数据类型或构造类型
int a[10]; struct Stu boy[10]通常情况下,数组元素下标的个数也称为维数,根据维数的不同,可将数组分为一维数组、二维数组、三维数组、四维数组等。通常情况下,<font color="red">我们将二维及以上的数组称为多维数组</font>1
2
3
4
5
6
7
- 按数组元素类型的不同,数组可分为:数值数组、字符数组、指针数组、结构数组等类别
- ```c
int a[10];
char s[10];
char *p[10];
一维数组
一维数组的定义和使用
数组名字符合标识符的书写规定(数字、英文字母、下划线)
数组名不能与其它变量名相同,同一作用域内是唯一的
方括号[]中常量表达式表示数组元素的个数
int a[3]表示数组a有3个元素 其下标从0开始计算,因此3个元素分别a[0],a[1],a[2]1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
- <font color="red">定义数组时[]内最好是常量,使用数组时[]内即可是常量,也可以是变量</font>
```c
#include <stdio.h>
int main()
{
int a[10];//定义了一个数组,名字叫a,有10个成员,每个成员都是int类型
//a[0]…… a[9],没有a[10]
//没有a这个变量,a是数组的名字,但不是变量名,它是常量
a[0] = 0;
//……
a[9] = 9;
int i = 0;
for (i = 0; i < 10; i++)
{
a[i] = i; //给数组赋值
}
//遍历数组,并输出每个成员的值
for (i = 0; i < 10; i++)
{
printf("%d ", a[i]);
}
printf("\n");
return 0;
}
输出结果:
1 | tao@Taoc:~/Desktop/C/5$ ./5.2.1 |
一维数组的初始化
在定义数组的同时进行赋值,称为初始化。全局数组若不初始化,编译器将其初始化为零。局部数组若不初始化,内容为随机值。
1 | int a[10] = { 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 };//定义一个数组,同时初始化所有成员变量 |
数组名
数组名是一个地址的常量,代表数组中首元素的地址
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/5$ ./5.2.3 |
二维数组
二维数组的定义和使用
二维数组定义的一般形式是:
类型说明符 数组名[常量表达式1][常量表达式2]
其中常量表达式1表示第一维下标的长度,常量表达式2 表示第二维下标的长度。
int a[3][4];
- 命名规则同一维数组
- 定义了一个三行四列的数组,数组名为a其元素类型为整型,该数组的元素个数为3×4个,即:
![[img/clip_image002-1600585634394.png]]
二维数组a是按行进行存放的,先存放a[0]行,再存放a[1]行、a[2]行,并且每行有四个元素,也是依次存放的
- 二维数组在概念上是二维的:其下标在两个方向上变化,对其访问一般需要两个下标。
- 在内存中并不存在二维数组,二维数组实际的硬件存储器是连续编址的,也就是说内存中只有一维数组,即放完一行之后顺次放入第二行,和一维数组存放方式是一样的。
1 |
|
二维数组的初始化
1 | //分段赋值 int a[3][4] = {{ 1, 2, 3, 4 },{ 5, 6, 7, 8, },{ 9, 10, 11, 12 }}; |
数组名
数组名是一个地址的常量,代表数组中首元素的地址
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/5$ ./5.3.3 |
强化训练
1 | #include <stdio.h> |
输出结果:
1 | tao@Taoc:~/Desktop/C/5$ ./5.3.4 |
多维数组(了解)
多维数组的定义与二维数组类似,其语法格式具体如下:
数组类型修饰符 数组名 [n1][n2]…[nn];
1 | int a[3][4][5]; |
定义了一个三维数组,数组的名字是a,数组的长度为3,每个数组的元素又是一个二维数组,这个二维数组的长度是4,并且这个二维数组中的每个元素又是一个一维数组,这个一维数组的长度是5,元素类型是int;
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/5$ ./5.4 |
字符数组与字符串
字符数组与字符串区别
- C语言中没有字符串这种数据类型,可以通过char的数组来替代;
- 字符串一定是一个char的数组,但char的数组未必是字符串;
- 数字0(和字符‘
\0’等价)结尾的char数组就是一个字符串,但如果char数组没有以数字0结尾,那么就不是一个字符串,只是普通字符数组,所以字符串是一种特殊的char的数组
1 |
|
![[img/image-20200920211035690.png]]
字符串的初始化
1 |
|
字符串的输入输出
由于字符串采用了’\0’标志,字符串的输入输出将变得简单方便
1 |
|
1. gets()
1 |
|
功能:从标准输入读入字符,并保存到s指定的内存空间,直到出现换行符或读到文件结尾为止。
参数:
s:字符串首地址
返回值:
成功:读入的字符串
失败:NULL
gets(str)与scanf(“%s”,str)的区别:
gets(str)允许输入的字符串含有空格scanf(“%s”,str)不允许含有空格
注意:由于
scanf()和gets()无法知道字符串s大小,必须遇到换行符或读到文件结尾为止才接收输入,因此容易导致字符数组越界(缓冲区溢出)的情况
1 | char str[100]; |
2. fgets()
1 |
|
功能:从stream指定的文件内读入字符,保存到s所指定的内存空间,直到出现换行字符、读到文件结尾或是已读了
size - 1个字符为止,最后会自动加上字符 ‘\0‘ 作为字符串结束。
参数:
s:字符串
size:指定最大读取字符串的长度(size - 1)
stream:文件指针,如果读键盘输入的字符串,固定写为stdin
返回值:
成功:成功读取的字符串
读到文件尾或出错: NULL
fgets()在读取一个用户通过键盘输入的字符串的时候,同时把用户输入的回车也做为字符串的一部分。通过scanf和gets输入一个字符串的时候,不包含结尾的“\n”,但通过fgets结尾多了“\n”。fgets()函数是安全的,不存在缓冲区溢出的问题
1 | char str[100]; |
3. puts()
1 |
|
功能:标准设备输出s字符串,在输出完成后自动输出一个’\n’。
参数:
s:字符串首地址
返回值:
成功:非负数
失败:-1
1 |
|
4. fputs()
1 |
|
功能:将str所指定的字符串写入到stream指定的文件中, 字符串结束符 ‘\0’ 不写入文件。
参数:
str:字符串
stream:文件指针,如果把字符串输出到屏幕,固定写为stdout
返回值:
成功:0
失败:-1
fputs()是puts()的文件操作版本,但fputs()不会自动输出一个’\n‘
1 | printf("hello world"); |
5. strlen()
1 |
|
功能:计算指定指定字符串s的长度,不包含字符串结束符‘
\0’参数:
s:字符串首地址
返回值:字符串s的长度,size_t为unsigned int类型
1 | char str[] = "abc\0defg"; |
字符串追加
1 |
|
C语言-函数
概述
函数分类
C 程序是由函数组成的,我们写的代码都是由主函数 main()开始执行的。函数是 C 程序的基本模块,是用于完成特定任务的程序代码单元
从函数定义的角度看,函数可分为系统函数和用户定义函数两种:
系统函数,即库函数:这是由编译系统提供的,用户不必自己定义这些函数,可以直接使用它们,如我们常用的打印函数printf()。
用户定义函数:用以解决用户的专门需要
函数的作用
函数的使用可以省去重复代码的编写,降低代码重复率
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/6$ ./6.1.2 |
函数可以让程序更加模块化,从而有利于程序的阅读,修改和完善
假如我们编写一个实现以下功能的程序:读入一行数字;对数字进行排序;找到它们的平均值;打印出一个柱状图。如果我们把这些操作直接写在main()里,这样可能会给用户感觉代码会有点凌乱。但,假如我们使用函数,这样可以让程序更加清晰、模块化:
1 |
|
这里我们可以这么理解,程序就像公司,公司是由部门组成的,这个部门就类似于C程序的函数。默认情况下,公司就是一个大部门( 只有一个部门的情况下 ),相当于C程序的main()函数。如果公司比较小( 程序比较小 ),因为任务少而简单,一个部门即可( main()函数 )胜任。但是,如果这个公司很大( 大型应用程序 ),任务多而杂,如果只是一个部门管理( 相当于没有部门,没有分工 ),我们可想而知,公司管理、运营起来会有多混乱,不是说这样不可以运营,只是这样不完美而已,如果根据公司要求分成一个个部门( 根据功能封装一个一个函数 ),招聘由行政部门负责,研发由技术部门负责等,这样就可以分工明确,结构清晰,方便管理,各部门之间还可以相互协调
函数的调用:产生随机数
当调用函数时,需要关心5要素:
头文件:包含指定的头文件
函数名字:函数名字必须和头文件声明的名字一样
功能:需要知道此函数能干嘛后才调用
参数:参数类型要匹配
返回值:根据需要接收返回值
1 |
|
功能:获取当前系统时间
参数:常设置为NULL
返回值:当前系统时间, time_t 相当于long类型,单位为毫秒
1 |
|
功能:用来设置
rand()产生随机数时的随机种子参数:如果每次seed相等,
rand()产生随机数相等返回值:无
1 |
|
功能:返回一个随机数值
参数:无
返回值:随机数
函数的定义
函数定义格式
函数定义的一般形式:
1 | 返回类型 函数名(形式参数列表) |
![[img/clip_image002-1600753669406.jpg]]
函数名字、形参、函数体、返回值
1. 函数名
理论上是可以随意起名字,最好起的名字见名知意,应该让用户看到这个函数名字就知道这个函数的功能。注意,函数名的后面有个圆换号(),代表这个为函数,不是普通的变量名。
2. 形参列表
在定义函数时指定的形参,在未出现函数调用时,它们并不占内存中的存储单元,因此称它们是形式参数或虚拟参数,简称形参,表示它们并不是实际存在的数据,所以,形参里的变量不能赋值
1 | void max(int a = 10, int b = 20) // error, 形参不能赋值 |
在定义函数时指定的形参,必须是,类型+变量的形式:
1 | //1: right, 类型+变量 |
在定义函数时指定的形参,可有可无,根据函数的需要来设计,如果没有形参,圆括号内容为空,或写一个void关键字:
1 | // 没形参, 圆括号内容为空 |
3. 函数体
花括号{ }里的内容即为函数体的内容,这里为函数功能实现的过程,这和以前的写代码没太大区别,以前我们把代码写在main()函数里,现在只是把这些写到别的函数里。
4. 返回值
函数的返回值是通过函数中的return语句获得的,return后面的值也可以是一个表达式
- 尽量保证return语句中表达式的值和函数返回类型是同一类型
1 | int max() // 函数的返回值为int类型 |
- 如果函数返回的类型和return语句中表达式的值不一致,则以函数返回类型为准,即函数返回类型决定返回值的类型。对数值型数据,可以自动进行类型转换
1 | double max() // 函数的返回值为double类型 |
注意:如果函数返回的类型和return语句中表达式的值不一致,而它又无法自动进行类型转换,程序则会报错
- return语句的另一个作用为中断return所在的执行函数,类似于break中断循环、switch语句一样
1 | int max() |
- 如果函数带返回值,return后面必须跟着一个值,如果函数没有返回值,函数名字的前面必须写一个
void关键字,这时候,我们写代码时也可以通过return中断函数(也可以不用),只是这时,return后面不带内容( 分号“;”除外)
1 | void max()// 最好要有void关键字 |
函数的调用
定义函数后,我们需要调用此函数才能执行到这个函数里的代码段。这和main()函数不一样,main()为编译器设定好自动调用的主函数,无需人为调用,我们都是在main()函数里调用别的函数,一个 C 程序里有且只有一个main()函数
函数执行流程
1 |
|
- 1.进入
mian()函数 - 2.调用
print_test()函数- a. 它会在main()函数的前寻找有没有一个名字叫“print_test”的函数定义;
- b. 如果找到,接着检查函数的参数,这里调用函数时没有传参,函数定义也没有形参,参数类型匹配;
- c. 开始执行
print_test()函数,这时候,main()函数里面的执行会阻塞( 停 )在print_test()这一行代码,等待print_test()函数的执行
print_test()函数执行完( 这里打印一句话 ),main()才会继续往下执行,执行到return 0, 程序执行完毕
函数的形参和实参
- 形参出现在函数定义中,在整个函数体内都可以使用,离开该函数则不能使用
- 实参出现在主调函数中,进入被调函数后,实参也不能使用
- 实参变量对形参变量的数据传递是“值传递”,即单向传递,只由实参传给形参,而不能由形参传回来给实参
- 在调用函数时,编译系统临时给形参分配存储单元。调用结束后,形参单元被释放
- 实参单元与形参单元是不同的单元。调用结束后,形参单元被释放,函数调用结束返回主调函数后则不能再使用该形参变量。实参单元仍保留并维持原值。因此,在执行一个被调用函数时,形参的值如果发生改变,并不会改变主调函数中实参的值
无参函数调用
如果是调用无参函数,则不能加上“实参”,但括号不能省略
1 | // 函数的定义 |
有参函数调用
如果实参表列包含多个实参,则各参数间用逗号隔开
1 | // 函数的定义 |
- 实参与形参的个数应相等,类型应匹配(相同或赋值兼容)。实参与形参按顺序对应,一对一地传递数据
- 实参可以是常量、变量或表达式,无论实参是何种类型的量,在进行函数调用时,它们都必须具有确定的值,以便把这些值传送给形参。所以,这里的变量是在圆括号( )外面定义好、赋好值的变量
1 | // 函数的定义 |
函数返回值
如果函数定义没有返回值,函数调用时不能写
void关键字,调用函数时也不能接收函数的返回值
1 | // 函数的定义 |
如果函数定义有返回值,这个返回值我们根据用户需要可用可不用,但是,假如我们需要使用这个函数返回值,我们需要定义一个匹配类型的变量来接收
1 | // 函数的定义, 返回值为int类型 |
函数的声明
如果使用用户自己定义的函数,而该函数与调用它的函数(即主调函数)不在同一文件中,或者函数定义的位置在主调函数之后,则必须在调用此函数之前对被调用的函数作声明
所谓函数声明,就是在函数尚在未定义的情况下,事先将该函数的有关信息通知编译系统,相当于告诉编译器,函数在后面定义,以便使编译能正常进行
注意:一个函数只能被定义一次,但可以声明多次
1 |
|
函数定义和声明的区别:
- 定义是指对函数功能的确立,包括指定函数名、函数类型、形参及其类型、函数体等,它是一个完整的、独立的函数单位
- 声明的作用则是把函数的名字、函数类型以及形参的个数、类型和顺序(注意,不包括函数体)通知编译系统,以便在对包含函数调用的语句进行编译时,据此对其进行对照检查(例如函数名是否正确,实参与形参的类型和个数是否一致)
main函数与exit函数
在main函数中调用exit和return结果是一样的,但在子函数中调用return只是代表子函数终止了,在子函数中调用exit,那么程序终止
1 |
|
多文件(分文件)编程
分文件编程
- 把函数声明放在头文件
xxx.h中,在主函数中包含相应头文件 - 在头文件对应的
xxx.c中实现xxx.h声明的函数
![[img/clip_image002-1600778555216.jpg]]
防止头文件重复包含
当一个项目比较大时,往往都是分文件,这时候有可能不小心把同一个头文件 include 多次,或者头文件嵌套包含
a.h 中包含 b.h :#include "b.h"
b.h 中包含 a.h:#include "a.h"
main.c中使用其中头文件:
1 |
|
编译报错!!!
为了避免同一个文件被include多次,C/C++中有两种方式解决:
法1:
1
2
3
4
// 声明语句法2:
1
2
// 声明语句
C语言-指针
概述
内存
内存含义:
存储器:计算机的组成中,用来存储程序和数据,辅助CPU进行运算处理的重要部分。
内存:内部存贮器,暂存程序/数据——掉电丢失 SRAM、DRAM、DDR、DDR2、DDR3。
外存:外部存储器,长时间保存程序/数据—掉电不丢ROM、ERRROM、FLASH(NAND、NOR)、硬盘、光盘
内存是沟通CPU与硬盘的桥梁:
暂存放CPU中的运算数据
暂存与硬盘等外部存储器交换的数据
物理存储器和存储地址空间
有关内存的两个概念:物理存储器和存储地址空间
物理存储器:实际存在的具体存储器芯片。
主板上装插的内存条
显示卡上的显示RAM芯片
各种适配卡上的RAM芯片和ROM芯片
存储地址空间:对存储器编码的范围。我们在软件上常说的内存是指这一层含义
- 编码:对每个物理存储单元(一个字节)分配一个号码
- 寻址:可以根据分配的号码找到相应的存储单元,完成数据的读写
内存地址
将内存抽象成一个很大的一维字符数组
编码就是对内存的每一个字节分配一个32位或64位的编号(与32位或者64位处理器相关)
这个内存编号我们称之为内存地址。
内存中的每一个数据都会分配相应的地址:
char:占一个字节分配一个地址int: 占四个字节分配四个地址float、struct、函数、数组等
![[img/clip_image002-1600782355725.png]]
指针和指针变量
- 内存区的每一个字节都有一个编号,这就是“地址”
- 如果在程序中定义了一个变量,在对程序进行编译或运行时,系统就会给这个变量分配内存单元,并确定它的内存地址(编号)
- 指针的实质就是内存“地址”。指针就是地址,地址就是指针
- 指针是内存单元的编号,指针变量是存放地址的变量
- 通常我们叙述时会把指针变量简称为指针,实际他们含义并不一样
![[img/clip_image002-1600782473718.png]]
指针基础知识
指针变量的定义和使用
指针也是一种数据类型,指针变量也是一种变量
指针变量指向谁,就把谁的地址赋值给指针变量
“*”操作符操作的是指针变量指向的内存空间
1 |
|
注意:
&可以取得一个变量在内存中的地址。但是,不能取寄存器变量,因为寄存器变量不在内存里,而在CPU里面,所以是没有地址的
1 | tao@Taoc:~/Desktop/C/7$ ./7.2.1 |
通过指针间接修改变量的值
1 | int a = 0; |
指针大小
- 使用sizeof()测量指针的大小,得到的总是:4或8
sizeof()测的是指针变量指向存储地址的大小- 在32位平台,所有的指针(地址)都是32位(4字节)
- 在64位平台,所有的指针(地址)都是64位(8字节)
1 |
|
输出结果:
1 | sizeof(p1) = 8 |
野指针和空指针
指针变量也是变量,是变量就可以任意赋值,不要越界即可(32位为4字节,64位为8字节),但是,任意数值赋值给指针变量没有意义,因为这样的指针就成了野指针,此指针指向的区域是未知(操作系统不允许操作此指针指向的内存区域)。所以,野指针不会直接引发错误,操作野指针指向的内存区域才会出问题。
1 | int a = 100; |
但是,野指针和有效指针变量保存的都是数值,为了标志此指针变量没有指向任何变量(空闲可用),C语言中,可以把NULL赋值给此指针,这样就标志此指针为空指针,没有任何指针
1 | int *p = NULL; |
NULL是一个值为0的宏常量:
1 |
万能指针void *
void *指针可以指向任意变量的内存空间
1 | void *p = NULL; |
const修饰的指针变量
1 | int a = 100; |
在编辑程序时,指针作为函数参数,如果不想修改指针对应内存空间的值,需要使用const修饰指针数据类型
指针和数组
数组名
数组名字是数组的首元素地址,但它是一个地址常量:
1 | int a[] = { 1, 2, 3, 4, 5, 6, 7, 8, 9 }; |
指针操作数组元素
1 |
|
1 | tao@Taoc:~/Desktop/C/7$ ./7.3.2 |
指针加减运算
1. 加法运算
- 指针计算不是简单的整数相加
- 如果是一个
int *,+1的结果是增加一个int的大小 - 如果是一个
char *,+1的结果是增加一个char大小
1 |
|
通过改变指针指向操作数组元素:
1 |
|
2. 减法运算
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/7$ ./7.3.3-2 |
1 |
|
指针数组
指针数组,它是数组,数组的每个元素都是指针类型
1 |
|
多级指针
- C语言允许有多级指针存在,在实际的程序中一级指针最常用,其次是二级指针
- 二级指针就是指向一个一级指针变量地址的指针
- 三级指针基本用不着,但考试会考
1 | int a = 10; |
指针和函数
函数形参改变实参的值
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/7$ ./7.5.1 |
数组名做函数参数
数组名做函数参数,函数的形参会退化为指针:
1 |
|
输出结果:
1 | 1, 2, 3, 4, 5, 6, 7, 8, 9, |
指针做为函数的返回值
1 |
|
指针和字符串
字符指针
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/7$ ./7.6.1 |
字符指针做函数参数
1 |
|
输出结果;
1 | tao@Taoc:~/Desktop/C/7$ ./7.7.3 |
const 修饰的指针变量
1 |
|
指针数组做为main函数的形参
1 | int main(int argc, char *argv[]); |
main函数是操作系统调用的,第一个参数标明argc数组的成员数量,argv数组的每个成员都是char *类型argv是命令行参数的字符串数组argc代表命令行参数的数量,程序名字本身算一个参数
1 |
|
项目开发常用字符串应用模型
1. strstr中的while和do-while模型
利用strstr标准库函数找出一个字符串中substr出现的个数
a. while模型
1 |
|
b. do-while
1 |
|
2. 两头堵模型
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/7$ ./7.6.5-2 |
3. 字符串反转模型(逆置)
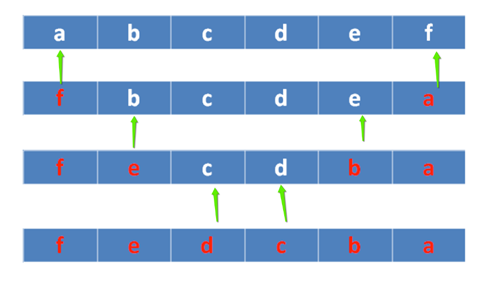
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/7$ ./7.6.5-3 |
字符串处理函数
1. strcpy()
1 |
|
功能:把src所指向的字符串复制到dest所指向的空间中,‘\0’也会拷贝过去
参数:
dest:目的字符串首地址
src:源字符首地址
返回值:
成功:返回dest字符串的首地址
失败:NULL
注意:如果参数dest所指的内存空间不够大,可能会造成缓冲溢出的错误情况
1 | char dest[20] = "123456789"; |
2. strncpy()
1 |
|
功能:把src指向字符串的前n个字符复制到dest所指向的空间中,是否拷贝结束符看指定的长度是否包含’\0’。>
参数:
dest:目的字符串首地址
src:源字符首地址
n:指定需要拷贝字符串个数
返回值:
成功:返回dest字符串的首地址
失败:NULL
1 | char dest[20] ; |
3. strcat()
1 |
|
功能:将src字符串连接到dest的尾部,‘\0’也会追加过去
参数:
dest:目的字符串首地址
src:源字符首地址
返回值:
成功:返回dest字符串的首地址
失败:NULL
1 | char str[20] = "123"; |
4. strncat
1 |
|
功能:将src字符串前n个字符连接到dest的尾部,‘\0’也会追加过去
参数:
dest:目的字符串首地址
src:源字符首地址
n:指定需要追加字符串个数
返回值:
成功:返回dest字符串的首地址
失败:NULL
1 | char str[20] = "123"; |
5. strcmp
1 |
|
功能:比较 s1 和 s2 的大小,比较的是字符ASCII码大小。
参数:
s1:字符串1首地址
s2:字符串2首地址
返回值:
相等:0
大于:>0 在不同操作系统strcmp结果会不同 返回ASCII差值
小于:<0
1 | char *str1 = "hello world"; |
6. strncmp()
1 |
|
功能:比较 s1 和 s2 前n个字符的大小,比较的是字符ASCII码大小。
参数:
s1:字符串1首地址
s2:字符串2首地址
n:指定比较字符串的数量
返回值:
相等:0
大于: > 0
小于: < 0
1 | char *str1 = "hello world"; |
7. sprintf()
1 |
|
功能:根据参数format字符串来转换并格式化数据,然后将结果输出到str指定的空间中,直到出现字符串结束符 ‘
\0‘ 为止。参数:
str:字符串首地址
format:字符串格式,用法和printf()一样
返回值:
成功:实际格式化的字符个数
失败: - 1
1 | char dst[100] = { 0 }; |
8. sscanf()
1 |
|
功能:从str指定的字符串读取数据,并根据参数format字符串来转换并格式化数据。
参数:
str:指定的字符串首地址
format:字符串格式,用法和scanf()一样
返回值:
成功:参数数目,成功转换的值的个数
失败: - 1
1 | char src[] = "a=10, b=20"; |
9.strchr()
1 |
|
功能:在字符串s中查找字母c出现的位置
参数:
s:字符串首地址
c:匹配字母(字符)
返回值:
成功:返回第一次出现的c地址
失败:NULL
1 | char src[] = "ddda123abcd"; |
10. strstr()
1 |
|
功能:在字符串haystack中查找字符串needle出现的位置
参数:
haystack:源字符串首地址
needle:匹配字符串首地址
返回值:
成功:返回第一次出现的needle地址
失败:NULL
1 | char src[] = "ddddabcd123abcd333abcd"; |
11. strtok()
1 |
|
功能:来将字符串分割成一个个片段。当
strtok()在参数s的字符串中发现参数delim中包含的分割字符时, 则会将该字符改为\0 字符,当连续出现多个时只替换第一个为\0。参数:
str:指向欲分割的字符串
delim:为分割字符串中包含的所有字符
返回值:
成功:分割后字符串首地址
失败:NULL
- 在第一次调用时:
strtok()必需给予参数s字符串 - 往后的调用则将参数s设置成NULL,每次调用成功则返回指向被分割出片段的指针
1 | char a[100] = "adc*fvcv.ebcy*hghbdfg$casdert"; |
12. atoi()
1 |
|
功能:
atoi()会扫描nptr字符串,跳过前面的空格字符,直到遇到数字或正负号才开始做转换,而遇到非数字或字符串结束符(‘\0’)才结束转换,并将结果返回返回值。参数:
nptr:待转换的字符串
返回值:成功转换后整数
类似的函数有:
atof():把一个小数形式的字符串转化为一个浮点数atol():将一个字符串转化为long类型
1 | char str1[] = " -10"; |
指针小结
| 定义 | 说明 |
|---|---|
int i |
定义整形变量 |
int *p |
定义一个指向int的指针变量 |
int a[10] |
定义一个有10个元素的数组,每个元素类型为int |
int *p[10] |
定义一个有10个元素的数组,每个元素类型为int* |
int func() |
定义一个函数,返回值为int型 |
int *func() |
定义一个函数,返回值为int *型 |
int **p |
定义一个指向int的指针的指针,二级指针 |
C语言-内存管理
作用域
C语言变量的作用域分为:
代码块作用域(代码块是{}之间的一段代码)
函数作用域
文件作用域
局部变量
局部变量也叫auto自动变量(auto可写可不写),一般情况下代码块{}内部定义的变量都是自动变量,它有如下特点:
- 在一个函数内定义,只在函数范围内有效
- 在复合语句中定义,只在复合语句中有效
- 随着函数调用的结束或复合语句的结束局部变量的声明声明周期也结束
- 如果没有赋初值,内容为随机
1 |
|
静态(static)局部变量
- static局部变量的作用域也是在定义的函数内有效
- static局部变量的生命周期和程序运行周期一样,同时staitc局部变量的值只初始化一次,但可以赋值多次,也就是说,初始化语句
static int i = 1只执行一次,后续再遇到就会直接不执行 - static局部变量若未赋以初值,则由系统自动赋值:数值型变量自动赋初值0,字符型变量赋空字符
1 |
|
全局变量
- 在函数外定义,可被本文件及其它文件中的函数所共用,若其它文件中的函数调用此变量,须用
extern声明 - 全局变量的生命周期和程序运行周期一样
- 不同文件的全局变量不可重名
静态(static)全局变量
- 在函数外定义,作用范围被限制在所定义的文件中
- 不同文件静态全局变量可以重名,但作用域不冲突
static全局变量的生命周期和程序运行周期一样,同时staitc全局变量的值只初始化一次
extern全局变量声明
extern int a;声明一个变量,这个全局变量在别的文件中已经定义了,这里只是声明,而不是定义
全局函数和静态函数
在C语言中函数默认都是全局的,使用关键字static可以将函数声明为静态,函数定义为static就意味着这个函数只能在定义这个函数的文件中使用,在其他文件中不能调用,即使在其他文件中声明这个函数都没用
对于不同文件中的staitc函数名字可以相同
![[img/clip_image002-1601020859989.jpg]]
注意:
允许在不同的函数中使用相同的变量名,它们代表不同的对象,分配不同的单元,互不干扰。
同一源文件中,允许全局变量和局部变量同名,在局部变量的作用域内,全局变量不起作用。
所有的函数默认都是全局的,意味着所有的函数都不能重名,但如果是
staitc函数,那么作用域是文件级的,所以不同的文件static函数名是可以相同的
总结
| 类型 | 作用域 | 生命周期 |
|---|---|---|
| auto变量 | 一对{}内 | 当前函数 |
| static局部变量 | 一对{}内 | 整个程序运行期 |
| extern变量 | 整个程序 | 整个程序运行期 |
| static全局变量 | 当前文件 | 整个程序运行期 |
| extern函数 | 整个程序 | 整个程序运行期 |
| static函数 | 当前文件 | 整个程序运行期 |
| register变量 | 一对{}内 | 当前函数 |
| 全局变量 | 整个程序 | 整个程序运行期 |
内存布局
内存分区
C代码经过预处理、编译、汇编、链接4步后生成一个可执行程序。
在 Windows 下,程序是一个普通的可执行文件,以下列出一个二进制可执行文件的基本情况:
![[img/image-20200925161021903.png]]
通过上图可以得知,在没有运行程序前,也就是说程序没有加载到内存前,可执行程序内部已经分好3段信息,分别为代码区(text)、数据区(data)和未初始化数据区(bss)3 个部分(有些人直接把data和bss合起来叫做静态区或全局区)。
- 代码区
- 存放 CPU 执行的机器指令。通常代码区是可共享的(即另外的执行程序可以调用它),使其可共享的目的是对于频繁被执行的程序,只需要在内存中有一份代码即可。代码区通常是只读的,使其只读的原因是防止程序意外地修改了它的指令。另外,代码区还规划了局部变量的相关信息
- 全局初始化数据区/静态数据区(data段)
- 该区包含了在程序中明确被初始化的全局变量、已经初始化的静态变量(包括全局静态变量和局部静态变量)和常量数据(如字符串常量)
- 未初始化数据区(又叫 bss 区)
- 存入的是全局未初始化变量和未初始化静态变量。未初始化数据区的数据在程序开始执行之前被内核初始化为 0 或者空(NULL)
- 程序在加载到内存前,代码区和全局区(data和bss)的大小就是固定的,程序运行期间不能改变。然后,运行可执行程序,系统把程序加载到内存,除了根据可执行程序的信息分出代码区(text)、数据区(data)和未初始化数据区(bss)之外,还额外增加了栈区、堆区
![[img/clip_image002-1601021875042.jpg]]
代码区(text segment)
- 加载的是可执行文件代码段,所有的可执行代码都加载到代码区,这块内存是不可以在运行期间修改的。
未初始化数据区(BSS)
- 加载的是可执行文件BSS段,位置可以分开亦可以紧靠数据段,存储于数据段的数据(全局未初始化,静态未初始化数据)的生存周期为整个程序运行过程。
全局初始化数据区/静态数据区(data segment)
- 加载的是可执行文件数据段,存储于数据段(全局初始化,静态初始化数据,文字常量(只读))的数据的生存周期为整个程序运行过程。
栈区(stack)
- 栈是一种先进后出的内存结构,由编译器自动分配释放,存放函数的参数值、返回值、局部变量等。在程序运行过程中实时加载和释放,因此,局部变量的生存周期为申请到释放该段栈空间。
堆区(heap)
- 堆是一个大容器,它的容量要远远大于栈,但没有栈那样先进后出的顺序。用于动态内存分配。堆在内存中位于BSS区和栈区之间。一般由程序员分配和释放,若程序员不释放,程序结束时由操作系统回收
存储类型总结
| 类型 | 作用域 | 生命周期 | 存储位置 |
|---|---|---|---|
| auto变量 | 一对{}内 | 当前函数 | 栈区 |
| static局部变量 | 一对{}内 | 整个程序运行期 | 初始化在data段,未初始化在BSS段 |
| extern变量 | 整个程序 | 整个程序运行期 | 初始化在data段,未初始化在BSS段 |
| static全局变量 | 当前文件 | 整个程序运行期 | 初始化在data段,未初始化在BSS段 |
| extern函数 | 整个程序 | 整个程序运行期 | 代码区 |
| static函数 | 当前文件 | 整个程序运行期 | 代码区 |
| register变量 | 一对{}内 | 当前函数 | 运行时存储在CPU寄存器 |
| 字符串常量 | 当前文件 | 整个程序运行期 | data段 |
1 |
|
输出结果:
1 | tao@Taoc:~/Desktop/C/8$ ./8.2.2 |
内存操作函数
1. memset()
1 |
|
功能:将s的内存区域的前n个字节以参数c填入
参数:
s:需要操作内存s的首地址
c:填充的字符,c虽然参数为int,但必须是unsigned char , 范围为0~255
n:指定需要设置的大小
返回值:s的首地址
1 | int a[10]; |
2. memcpy()
1 |
|
功能:拷贝src所指的内存内容的前n个字节到dest所值的内存地址上。
参数:
dest:目的内存首地址
src:源内存首地址,注意:dest和src所指的内存空间不可重叠,可能会导致程序报错
n:需要拷贝的字节数
返回值:dest的首地址
1 | int a[10] = { 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 }; |
3. memmove()
memmove()功能用法和memcpy()一样,区别在于:dest和src所指的内存空间重叠时,memmove()仍然能处理,不过执行效率比memcpy()低些
4. memcmp()
1 |
|
功能:比较s1和s2所指向内存区域的前n个字节
参数:
s1:内存首地址1
s2:内存首地址2
n:需比较的前n个字节
返回值:
相等:=0
大于:>0
小于:<0
1 | int a[10] = { 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 }; |
堆区内存分配和释放
**1. malloc() **
1 |
|
功能:在内存的动态存储区(堆区)中分配一块长度为size字节的连续区域,用来存放类型说明符指定的类型。分配的内存空间内容不确定,一般使用memset初始化。
参数:
size:需要分配内存大小(单位:字节)
返回值:
成功:分配空间的起始地址
失败:NULL
1 |
|
输出结果:
1 | /8$ ./8.2.4-1 |
2. free()
1 |
|
功能:释放ptr所指向的一块内存空间,ptr是一个任意类型的指针变量,指向被释放区域的首地址。对同一内存空间多次释放会出错。
参数:
ptr:需要释放空间的首地址,被释放区应是由malloc函数所分配的区域。
返回值:无
内存分区代码分析
返回栈区地址
1 |
|
返回data区地址
1 |
|
值传递1
1 |
|
值传递2
1 |
|
返回堆区地址
1 |
|
C语言-复合类型
结构体
概述
数组:描述一组具有相同类型数据的有序集合,用于处理大量相同类型的数据运算
有时我们需要将不同类型的数据组合成一个有机的整体,如:一个学生有学号/姓名/性别/年龄/地址等属性。显然单独定义以上变量比较繁琐,数据不便于管理
C语言中给出了另一种构造数据类型——结构体
![[img/clip_image002-1601038402799.jpg]]
结构体变量的定义和初始化
定义结构体变量的方式:
先声明结构体类型再定义变量名
在声明类型的同时定义变量
直接定义结构体类型变量(无类型名)
![[img/clip_image002-1601038507385.jpg]]
结构体类型和结构体变量关系:
- 结构体类型:指定了一个结构体类型,它相当于一个模型,但其中并无具体数据,系统对之也不分配实际内存单元
- 结构体变量:系统根据结构体类型(内部成员状况)为之分配空间
1 | // 结构体类型的定义 |
结构体成员的使用
1 |
|
结构体数组
1 |
|
结构体套结构体
1 |
|
结构体赋值
1 |
|
结构体和指针
1. 指向普通结构体变量的指针
1 |
|
2. 堆区结构体变量
1 |
|
3. 结构体套一级指针
1 |
|
结构体做函数参数
1. 结构体普通变量做函数参数
1 |
|
2. 结构体指针变量做函数参数
1 |
|
4. const修饰结构体指针形参变量
1 | // 结构体类型的定义 |
共用体(联合体)
- 联合union是一个能在同一个存储空间存储不同类型数据的类型;
- 联合体所占的内存长度等于其最长成员的长度倍数,也有叫做共用体;
- 同一内存段可以用来存放几种不同类型的成员,但每一瞬时只有一种起作用;
- 共用体变量中起作用的成员是最后一次存放的成员,在存入一个新的成员后原有的成员的值会被覆盖;
- 共用体变量的地址和它的各成员的地址都是同一地址
1 |
|
枚举
枚举:将变量的值一一列举出来,变量的值只限于列举出来的值的范围内。
枚举类型定义:
1 | enum 枚举名 |
- 在枚举值表中应列出所有可用值,也称为枚举元素
- 枚举值是常量,不能在程序中用赋值语句再对它赋值
- 举元素本身由系统定义了一个表示序号的数值从0开始顺序定义为0,1,2 …
1 |
|
输出结果:
1 | Taoc:~/Desktop/C/9$ ./9.3 |
typedef
typedef为C语言的关键字,作用是为一种数据类型(基本类型或自定义数据类型)定义一个新名字,不能创建新类型
- 与
#define不同,typedef仅限于数据类型,而不是能是表达式或具体的值 #define发生在预处理,typedef发生在编译阶段
1 |
|
C语言-文件操作
概述
磁盘文件和设备文件
磁盘文件
- 指一组相关数据的有序集合,通常存储在外部介质(如磁盘)上,使用时才调入内存
设备文件
- 在操作系统中把每一个与主机相连的输入、输出设备看作是一个文件,把它们的输入、输出等同于对磁盘文件的读和写
磁盘文件的分类
计算机的存储在物理上是二进制的,所以物理上所有的磁盘文件本质上都是一样的:以字节为单位进行顺序存储
![[img/clip_image002-1601113908804.jpg]]
从用户或者操作系统使用的角度(逻辑上)把文件分为:
文本文件:基于字符编码的文件
二进制文件:基于值编码的文件
文本文件和二进制文件
1. 文本文件
基于字符编码,常见编码有ASCII、UNICODE等
一般可以使用文本编辑器直接打开
数5678的以ASCII存储形式(ASCII码)为:
00110101 00110110 00110111 00111000
2. 二进制文件
- 基于值编码,自己根据具体应用,指定某个值是什么意思
- 把内存中的数据按其在内存中的存储形式原样输出到磁盘上
- 数5678的存储形式(二进制码)为:
- 00010110 00101110
文件的打开和关闭
文件指针
在C语言中用一个指针变量指向一个文件,这个指针称为文件指针
1 | typedef struct |
FILE是系统使用typedef定义出来的有关文件信息的一种结构体类型,结构中含有文件名、文件状态和文件当前位置等信息
声明FILE结构体类型的信息包含在头文件“stdio.h”中,一般设置一个指向FILE类型变量的指针变量,然后通过它来引用这些FILE类型变量。通过文件指针就可对它所指的文件进行各种操作
![[img/clip_image002-1601123785585.png]]
C语言中有三个特殊的文件指针由系统默认打开,用户无需定义即可直接使用:
stdin:标准输入,默认为当前终端(键盘),我们使用的scanf、getchar函数默认从此终端获得数据stdout: 标准输出,默认为当前终端(屏幕),我们使用的printf、puts函数默认输出信息到此终端stderr: 标准出错,默认为当前终端(屏幕),我们使用的perror函数默认输出信息到此终端
文件的打开
任何文件使用之前必须打开:
1 |
|
功能:打开文件
参数:
filename:需要打开的文件名,根据需要加上路径
mode:打开文件的模式设置
返回值:
成功:文件指针
失败:NULL
第一个参数的几种形式:
1 | FILE *fp_passwd = NULL; |
第二个参数的几种形式(打开文件的方式):
| 打开模式 | 含义 |
|---|---|
| r或rb | 以只读方式打开一个文本文件(不创建文件,若文件不存在则报错) |
| w或wb | 以写方式打开文件(如果文件存在则清空文件,文件不存在则创建一个文件) |
| a或ab | 以追加方式打开文件,在末尾添加内容,若文件不存在则创建文件 |
| r+或rb+ | 以可读、可写的方式打开文件(不创建新文件) |
| w+或wb+ | 以可读、可写的方式打开文件(如果文件存在则清空文件,文件不存在则创建一个文件) |
| a+或ab+ | 以添加方式打开可读、可写的文件。若文件不存在则创建文件;如果文件存在,则写入的数据会被加到文件尾后,即文件原先的内容会被保留。 |
注意:
- b是二进制模式的意思,b只是在Windows有效,在Linux用r和rb的结果是一样的
- Unix和Linux下所有的文本文件行都是\n结尾,而Windows所有的文本文件行都是\r\n结尾
- 在Windows平台下,以“文本”方式打开文件,不加b:
- n 当读取文件的时候,系统会将所有的 “\r\n” 转换成 “\n”
- 当写入文件的时候,系统会将 “\n” 转换成 “\r\n” 写入
- n 以”二进制”方式打开文件,则读写都不会进行这样的转换
- 在Unix/Linux平台下,“文本”与“二进制”模式没有区别,”\r\n” 作为两个字符原样输入输出
1 | int main() |
文件的关闭
任何文件在使用后应该关闭:
- 打开的文件会占用内存资源,如果总是打开不关闭,会消耗很多内存
- 一个进程同时打开的文件数是有限制的,超过最大同时打开文件数,再次调用
fopen打开文件会失败 - 如果没有明确的调用
fclose关闭打开的文件,那么程序在退出的时候,操作系统会统一关闭
1 |
|
功能:关闭先前fopen()打开的文件。此动作让缓冲区的数据写入文件中,并释放系统所提供的文件资源。
参数:
stream:文件指针
返回值:
成功:0
失败:-1
1 | FILE * fp = NULL; |
文件的顺序读写
按照字符读写文件fgetc、fputc
1. 写文件
1 |
|
功能:将ch转换为unsigned char后写入stream指定的文件中
参数:
ch:需要写入文件的字符
stream:文件指针
返回值:
成功:成功写入文件的字符
失败:返回-1
1 | char buf[] = "My name is Tao."; |
2. 文件结尾
在C语言中,EOF表示文件结束符(end of file)。在while循环中以EOF作为文件结束标志,这种以EOF作为文件结束标志的文件,必须是文本文件。在文本文件中,数据都是以字符的ASCII代码值的形式存放。我们知道,ASCII代码值的范围是0~127,不可能出现-1,因此可以用EOF作为文件结束标志
1 |
当把数据以二进制形式存放到文件中时,就会有-1值的出现,因此不能采用EOF作为二进制文件的结束标志。为解决这一个问题,ANSI C提供一个feof函数,用来判断文件是否结束。feof函数既可用以判断二进制文件又可用以判断文本文件
1 |
|
功能:检测是否读取到了文件结尾。判断的是最后一次“读操作的内容”,不是当前位置内容(上一个内容)。
参数:
stream:文件指针
返回值:
非0值:已经到文件结尾
0:没有到文件结尾
3. 读文件
1 |
|
功能:从stream指定的文件中读取一个字符
参数:
stream:文件指针
返回值:
成功:返回读取到的字符
失败:-1
1 | char ch; |
按照行读写文件fgets、fputs
1. 写文件
1 |
|
功能:将str所指定的字符串写入到stream指定的文件中,字符串结束符 ‘
\0‘ 不写入文件。参数:
str:字符串
stream:文件指针
返回值:
成功:0
失败:-1
1 | char *buf[] = { "123456\n", "bbbbbbbbbb\n", "ccccccccccc\n" }; |
2. 读文件
1 |
|
功能:从stream指定的文件内读入字符,保存到str所指定的内存空间,直到出现换行字符、读到文件结尾或是已读了size - 1个字符为止,最后会自动加上字符 ‘\0’ 作为字符串结束。
参数:
str:字符串
size:指定最大读取字符串的长度(size - 1)
stream:文件指针
返回值:
成功:成功读取的字符串
读到文件尾或出错: NULL
1 | char buf[100] = {0}; |
强化训练:文件版四则运算
有个文件大小不确定,每行内容都是一个四则运算表达式,还没有算出结果,写一个程序,自动算出其结果后修改文件
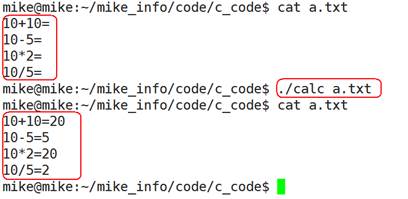
按照格式化文件fprintf、fscanf
- 写文件
1 |
|
功能:根据参数format字符串来转换并格式化数据,然后将结果输出到stream指定的文件中,指定出现字符串结束符 ‘\0’ 为止。
参数:
stream:已经打开的文件
format:字符串格式,用法和printf()一样
返回值:
成功:实际写入文件的字符个数
失败:-1
1 | fprintf(fp, "%d %d %d\n", 1, 2, 3); |
- 读文件
1 |
|
功能:从stream指定的文件读取字符串,并根据参数format字符串来转换并格式化数据。
参数:
stream:已经打开的文件
format:字符串格式,用法和scanf()一样
返回值:
成功:参数数目,成功转换的值的个数
失败: - 1
1 | int a = 0; |
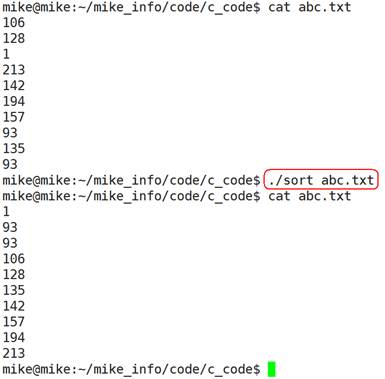
按照块读写文件fread、fwrite
- 写文件
1 |
|
功能:以数据块的方式给文件写入内容
参数:
ptr:准备写入文件数据的地址
size: size_t 为 unsigned int类型,此参数指定写入文件内容的块数据大小
nmemb:写入文件的块数,写入文件数据总大小为:size * nmemb
stream:已经打开的文件指针
返回值:
成功:实际成功写入文件数据的块数目,此值和 nmemb 相等
失败:0
1 | typedef struct Stu |
2. 读文件
1 |
|
功能:以数据块的方式从文件中读取内容
参数:
ptr:存放读取出来数据的内存空间
size: size_t 为 unsigned int类型,此参数指定读取文件内容的块数据大小
nmemb:读取文件的块数,读取文件数据总大小为:size * nmemb
stream:已经打开的文件指针
返回值:
成功:实际成功读取到内容的块数,如果此值比nmemb小,但大于0,说明读到文件的结尾。
失败:0
0: 表示读到文件结尾。(feof())
1 | typedef struct Stu |
文件的随机读写
1 |
|
功能:移动文件流(文件光标)的读写位置。
参数:
stream:已经打开的文件指针
offset:根据whence来移动的位移数(偏移量),可以是正数,也可以负数,如果正数,则相对于whence往右移动,如果是负数,则相对于whence往左移动。如果向前移动的字节数超过了文件开头则出错返回,如果向后移动的字节数超过了文件末尾,再次写入时将增大文件尺寸。
whence:其取值如下:
SEEK_SET:从文件开头移动offset个字节
SEEK_CUR:从当前位置移动offset个字节
SEEK_END:从文件末尾移动offset个字节
返回值:
成功:0
失败:-1
1 |
|
功能:获取文件流(文件光标)的读写位置。
参数:
stream:已经打开的文件指针
返回值:
成功:当前文件流(文件光标)的读写位置
失败:-1
1 |
|
功能:把文件流(文件光标)的读写位置移动到文件开头。
参数:
stream:已经打开的文件指针
返回值:
无返回值
1 | typedef struct Stu |
Windows和Linux文本文件区别
- b是二进制模式的意思,b只是在Windows有效,在Linux用r和rb的结果是一样的
- Unix和Linux下所有的文本文件行都是\n结尾,而Windows所有的文本文件行都是\r\n结尾
- 在Windows平台下,以“文本”方式打开文件,不加b:
- n 当读取文件的时候,系统会将所有的 “\r\n” 转换成 “\n”
- n 当写入文件的时候,系统会将 “\n” 转换成 “\r\n” 写入
- n 以”二进制”方式打开文件,则读\写都不会进行这样的转换
- 在Unix/Linux平台下,“文本”与“二进制”模式没有区别,”\r\n” 作为两个字符原样输入输出
判断文本文件是Linux格式还是Windows格式:
1 |
|
获取文件状态
1 | xxxxxxxxxx |
功能:获取文件状态信息
参数:
path:文件名
buf:保存文件信息的结构体
返回值:
成功:0
失败-1
1 | struct stat { |
1 |
|
删除文件、重命名文件名
1 |
|
功能:删除文件
参数:
pathname:文件名
返回值:
成功:0
失败:-1
1 |
|
功能:把oldpath的文件名改为newpath
参数:
oldpath:旧文件名
newpath:新文件名
返回值:
成功:0
失败: - 1
文件缓冲区
文件缓冲区
ANSI C标准采用“缓冲文件系统”处理数据文件。
所谓缓冲文件系统是指系统自动地在内存区为程序中每一个正在使用的文件开辟一个文件缓冲区从内存向磁盘输出数据必须先送到内存中的缓冲区,装满缓冲区后才一起送到磁盘去。
如果从磁盘向计算机读入数据,则一次从磁盘文件将一批数据输入到内存缓冲区(充满缓冲区),然后再从缓冲区逐个地将数据送到程序数据区(给程序变量) 。
磁盘文件的存取
![[img/clip_image002-1601186383431.jpg]]
- 磁盘文件,一般保存在硬盘、U盘等掉电不丢失的磁盘设备中,在需要时调入内存
- 在内存中对文件进行编辑处理后,保存到磁盘中
- 程序与磁盘之间交互,不是立即完成,系统或程序可根据需要设置缓冲区,以提高存取效率
更新缓冲区
1 |
|
功能:更新缓冲区,让缓冲区的数据立马写到文件中。
参数:
stream:文件指针
返回值:
成功:0
失败:-1